О проекте
Команда: DOGS
Кейс HackAlem.ai: Телеком — Beeline
Стадия: Доведённый продукт
Задача кейса: Агент, который решает, каким абонентам какой тариф предложить (чистый прирост ARPU)
Суть
Агент для планирования тарифных кампаний Beeline: проводит адаптивные пилоты, обновляет оценки и собирает портфель кампаний в пределах бюджета и лимита контактов. Есть React-рабочее место маркетолога и опциональный OpenAI-ассистент.
Как устроено
Исторические переходы между тарифами превращаются в слабые priors с сохранением неопределённости. Engine.next_pilot() выбирает следующий пилот через env.run_pilot там, где наблюдение может изменить план (учитываются неопределённость, охват, стоимость канала и остаток бюджета), а Engine.observe() обновляет оценку по шумному результату. Engine.solve() эвристически собирает упорядоченный портфель с учётом бюджета, контактов, пересечения аудиторий и правила «один клиент — эффект только от лучшей кампании». Планы хранятся неизменяемыми версиями; LLM-ассистент через function calling вызывает тот же детерминированный Engine для сценариев what-if.
Ключевые решения
- priors на исторических переходах
- адаптивный выбор пилотов (exploration)
- обновление оценок по шумным наблюдениям
- эвристический portfolio solver с ограничениями
- function calling
- structured outputs
- неизменяемые версии планов
Особенности
Задача решается как активное экспериментирование: агент тратит часть бюджета на пилоты там, где новое наблюдение может изменить решение, и перепроверяет крупные ставки. Результат официального scoring не возвращается в выбор кампаний. LLM не считает экономику сама, а только вызывает проверяемые инструменты. Сценарий никогда не применяется автоматически.
Стек
Python · NumPy · pandas · ThreadingHTTPServer · SQLite · React · TypeScript · Vite · OpenAI SDK · jsonschema
Модели
OpenAI GPT mini (Responses API)
Проект создан за 5 часов на финале хакатона HackAlem.ai (23 сентября 2026, Астана). Код — BAITC-Hacks/hack-6b518c43-dogs.
README
README.mdBeeAgent
powered by Beeline
Agentic AI-система для управления тарифными маркетинговыми кампаниями. BeeAgent сам решает, какие гипотезы стоит проверить, учится на пилотах, обновляет оценки и собирает исполнимый портфель кампаний в пределах бюджета и охвата.
Что решает BeeAgent
Планирование тарифных кампаний происходит в условиях неполной информации.
Исторические переходы относятся к другой аудитории. Даже привлекательный переход в истории не гарантирует такой же эффект на текущей клиентской базе. Маленький пилот слишком шумный, а большой пилот расходует тот же бюджет и охват, которые затем нужны основным кампаниям.
BeeAgent превращает эту неопределённость в управляемый цикл принятия решений:
- формирует гипотезы на основе исторических переходов и параметров тарифов;
- оценивает неопределённость и не принимает историю за истину;
- выбирает следующий пилот там, где новое наблюдение может изменить итоговый план;
- обновляет оценку после каждого результата;
- повторно проверяет крупные решения, если одного наблюдения недостаточно;
- собирает упорядоченный портфель кампаний с учётом бюджета, контактов и ограничений;
- показывает основания каждого решения;
- позволяет маркетологу менять бизнес-условия и сравнивать версии до применения.
BeeAgent выдаёт не просто рейтинг кампаний, а воспроизводимый процесс принятия решения с наблюдениями, версиями и журналом изменений.
Все данные кейса синтетические. Результаты проекта не отражают реальные показатели Beeline.
Что получает маркетолог
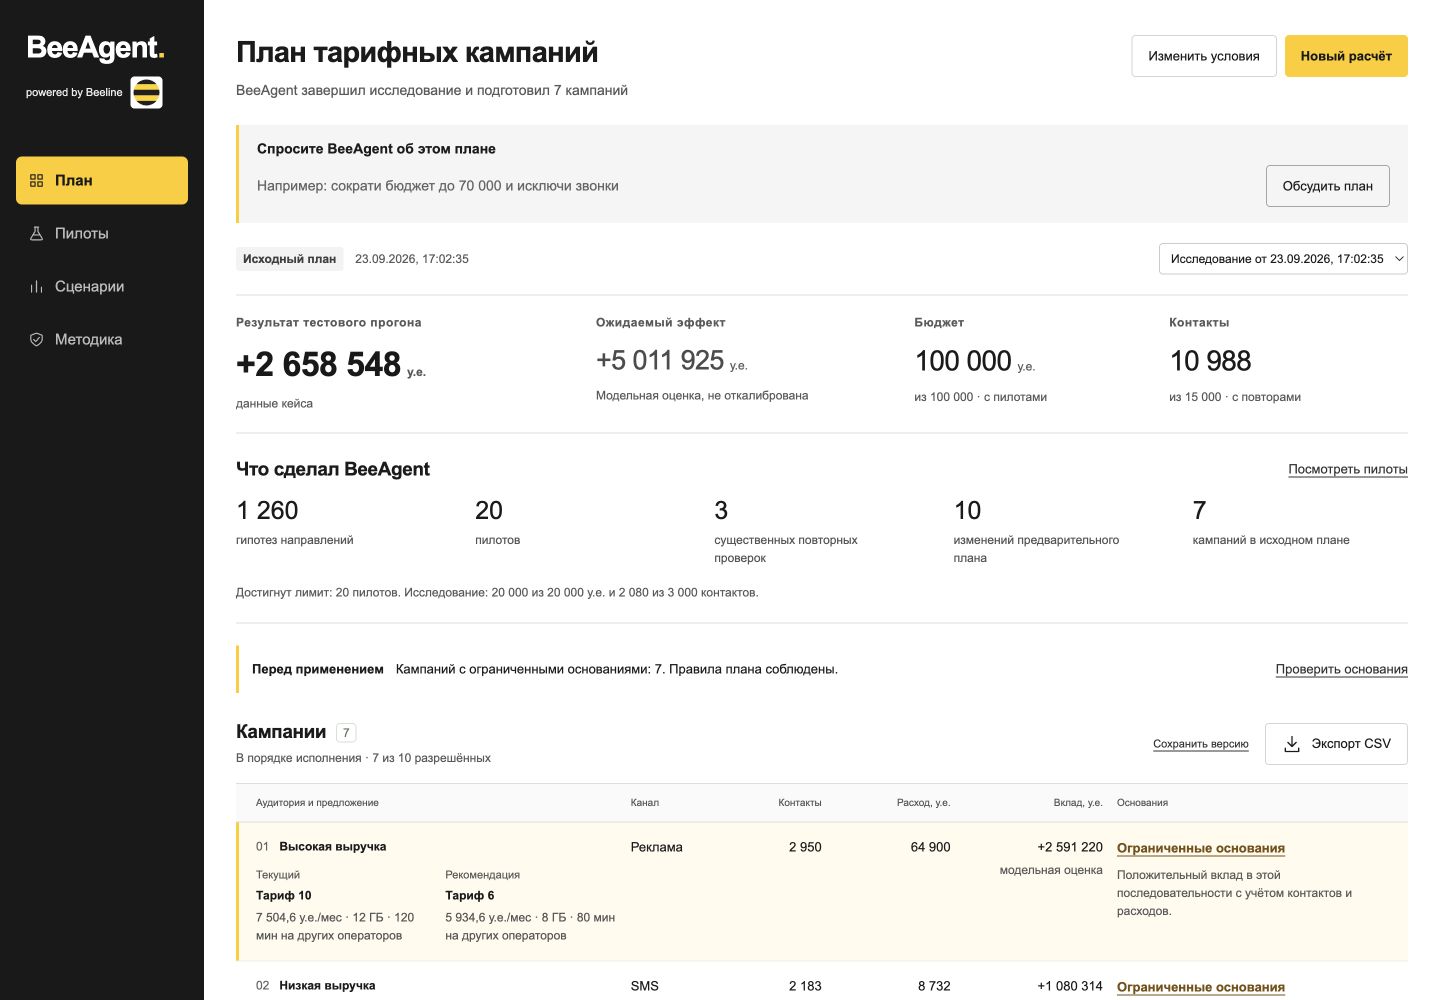
Рабочее пространство состоит из четырёх разделов:
- План - итоговый портфель кампаний, результат проверки, прогноз, ресурсы и основания решений.
- Пилоты - что BeeAgent проверял, что получил и как наблюдение изменило предварительный план.
- Сценарии - альтернативные бюджеты, каналы и ограничения со сравнением версий и явным применением.
- Методика - данные, допущения, ограничения модели и воспроизводимость.
С BeeAgent можно работать и обычным языком. Например:
Сократи бюджет на 30%, исключи звонки и оставь максимум пять кампанийПочему в этой кампании выбран SMS, а не звонок?Какие решения опираются на самые слабые основания?
LLM не считает экономику кампаний самостоятельно. Она вызывает проверяемые серверные инструменты, а расчёт выполняет тот же детерминированный Engine, который используется рабочим интерфейсом.
Быстрый запуск
Требования
Требования к локальному запуску:
- Python 3.11+
- Node.js 20.19+
- npm
- macOS или Linux shell для
run.sh
Чистая установка проверена на macOS arm64 с Python 3.12 и Node.js 20. Linux отдельно не проверялся.
Сам конкурсный агент не требует Node.js, web-сервера или OpenAI API.
Развёртывание с чистого клона
Для клонирования проверяющему нужен доступ к GitHub-репозиторию. Перед установкой убедитесь, что python3 --version показывает 3.11 или новее.
git clone https://github.com/BAITC-Hacks/hack-6b518c43-dogs.git
cd hack-6b518c43-dogs

python3 -m venv .venv
source .venv/bin/activate

python -m pip install -r requirements.txt -r requirements-server.txt
npm --prefix frontend ci

./run.sh
Открыть:
http://127.0.0.1:8765
run.sh при необходимости собирает frontend и запускает локальный backend. Внешняя база данных или облачное развёртывание для проверки не нужны.
Другой порт:
./run.sh --port 8766
Проверка за 3 минуты
После запуска приложения:
- Откройте План и нажмите
Новый расчёт. - Запустите расчёт. BeeAgent проведёт пилоты через публичный интерфейс среды и соберёт итоговый портфель.
- Откройте блок
Что сделал BeeAgent. В нём показаны гипотезы, пилоты, повторные проверки, изменения решений и причина остановки исследования. - Откройте любую кампанию и изучите
Основания решения. - Перейдите в Пилоты и откройте наблюдение, которое изменило предварительный план.
- Перейдите в Сценарии. Задайте бюджет
70 000, отключите звонки и установите максимум5кампаний. - Подготовьте вариант и сравните его с активным планом.
- Примените вариант вручную. BeeAgent никогда не применяет предложенный сценарий автоматически.
- Сохраните план, обновите страницу и экспортируйте CSV.
- При необходимости вернитесь к исходной измеренной версии.
Изменённый сценарий использует уже полученные наблюдения и не запускает новые пилоты.
Архитектура
flowchart TD
    D["Данные кейса и справочники тарифов"] --> H["Слой исторических гипотез"]
    P["Текущий профиль аудитории и лимиты"] --> E["BeeAgent Engine"]
    H --> E

    E --> X["Политика выбора эксперимента"]
    X --> R["env.run_pilot"]
    R --> O["Шумное наблюдение"]
    O --> U["Обновление оценки"]
    U --> E

    E --> G["Portfolio solver"]
    G --> C["Упорядоченный план кампаний"]
    C --> J["Официальный scoring после Agent.act"]

    E --> S["Снимок знаний и decision trace"]
    S --> PS["PlanService"]
    PS --> V["Неизменяемые версии планов"]
    V --> W["React workspace"]

    W --> A["Опциональный AI-ассистент"]
    A --> T["Проверяемые инструменты"]
    T --> PS

    PS --> EX["Сравнение, применение, сохранение, экспорт"]
Важная граница
Результат официального scoring не передаётся обратно в выбор кампаний.
Agent.act(env) использует только публичную среду, исторические файлы и наблюдения, полученные через env.run_pilot. Рабочий интерфейс и AI-ассистент используют тот же Engine через сохранённый снимок знаний. Отдельного демонстрационного рекомендателя нет.
Как работает агент
1. Исторические гипотезы
History в agent.py превращает исторические переходы между тарифами в слабые priors.
История рассматривается как ассоциация, а не доказанный causal uplift. Разреженные направления объединяются с более широкими статистиками и параметрами тарифов. Неопределённость сохраняется, потому что текущая аудитория отличается от исторической.
2. Адаптивная разведка
Engine.next_pilot() выбирает следующий эксперимент с учётом:
- возможного влияния на итоговое решение;
- текущей неопределённости;
- доступного охвата;
- стоимости канала;
- оставшегося бюджета и контактов;
- необходимости повторно подтвердить крупное решение.
Размер пилота не задан одной константой для всех случаев. Агент может выбирать разные размеры выборки и возвращаться к важным неопределённым направлениям.
3. Обновление знания
Engine.observe() обновляет оценку с учётом фактического числа контактов и полученного шумного эффекта.
Если первое наблюдение резко противоречит истории, система может увеличить неопределённость prior вместо безусловного доверия историческим данным.
4. Сборка портфеля
Engine.solve() строит упорядоченный портфель кампаний.
В расчёте учитываются:
- общий бюджет;
- общий лимит контактов;
- максимум контактов на кампанию;
- порядок кампаний;
- стоимость канала;
- пересечение аудиторий;
- повторные контакты;
- правило, что один клиент даёт эффект только от лучшей кампании.
Оптимизатор эвристический и не заявляет глобальный оптимум.
5. Основания и версии
Каждый запуск сохраняет:
- журнал пилотов;
- оценки до и после наблюдений;
- предварительные решения;
- финальный план;
- снимок знаний;
- идентичность версии;
- измеренный результат только для точно проверенной версии.
Альтернативные планы сохраняются как отдельные неизменяемые версии. Результат одной версии не переносится на другую.
Основные компоненты
| Компонент | Ответственность |
|---|---|
agent.py | Agent, priors, неопределённость, адаптивные пилоты, forecast ledger и portfolio solver |
environment.py | Публичная среда организаторов |
scoring_core.py | Механика официального scoring, используется без изменений |
backend/server.py | Локальный HTTP API, выполнение запусков, frontend и локальное хранилище |
backend/plans.py | Версии планов, пересчёт сценариев, сравнение, применение и CSV export |
backend/presentation.py | Понятные человеку summaries активности и оснований |
backend/assistant.py | Опциональная OpenAI orchestration с валидируемыми tools |
frontend/ | Рабочее место маркетингового аналитика |
tools/verify_submission.py | Единая воспроизводимая проверка сдачи |
reports/stage4/ | Текущие артефакты тестирования и сохранённые результаты |
Технологии
| Слой | Технологии |
|---|---|
| Decision engine | Python 3.11+, NumPy 2.3.5, pandas 2.2.3 |
| Local backend | Python ThreadingHTTPServer, JSON/CSV storage |
| Версии планов | Immutable JSON files |
| AI usage ledger | SQLite через стандартную библиотеку Python |
| Frontend | React 19.1.1, TypeScript 5.9.2, Vite 7.1.7 |
| AI assistant | OpenAI Python SDK 2.54.0, Responses API, function calling, structured outputs |
| Проверка структуры | jsonschema 4.26.0 |
| Local config | python-dotenv 1.2.3 |
| Verification | local_eval.py, make_submission.py, unit tests, browser checks |
Для локальной проверки не нужны внешняя БД, Docker, облачный backend или сторонняя авторизация.
OpenAI assistant
Конкурсный scoring не зависит от OpenAI.
Опциональный ассистент умеет:
- дать сводку активного плана;
- объяснить основания выбранной кампании;
- подготовить сценарий с новыми ограничениями;
- сравнить две версии плана.
Ассистент не может:
- самостоятельно применить план;
- запускать новые пилоты при what-if пересчёте;
- менять официальный
submission.csv; - придумывать числовые показатели вне валидированных ссылок backend.
Подключение
Без терминала: нажмите Обсудить план, затем Подключить OpenAI (или Настройка подключения, если ключ уже задан). Вставьте собственный ключ в скрытое поле и нажмите Сохранить ключ локально. Поле сразу очищается, перезапуск не требуется. Сохранение ключа не выполняет платного запроса.
Вариант через терминал:
source .venv/bin/activate
python tools/configure_ai.py
./run.sh
Ключ вводится скрыто и сохраняется только в локальном .env с правами 0600, который игнорируется Git. CLI не перезаписывает существующий файл; интерфейс позволяет заменить ключ, сохраняя лимиты и журнал расходов. В репозитории находится только шаблон .env.example без ключа.
Модель по умолчанию:
gpt-5.4-mini
Проверяющий может использовать собственный OPENAI_API_KEY. Все не-AI функции продолжают работать без ключа.
Переменные окружения
| Variable | Обязательна | Default | Назначение |
|---|---|---|---|
OPENAI_API_KEY | Нет | пусто | Включает серверный AI assistant |
OPENAI_MODEL | Нет | gpt-5.4-mini | Модель ассистента |
BEEAGENT_AI_BUDGET_USD | Нет | 3 | Локальный guardrail оценки расходов |
BEEAGENT_AI_MAX_CALLS | Нет | 100 | Максимум учтённых model calls |
BEEAGENT_STORAGE_DIR | Нет | reports/runs | Альтернативное локальное хранилище |
BEEAGENT_INPUT_USD_PER_MILLION | Для неизвестной модели | model default | Локальная оценка input cost |
BEEAGENT_CACHED_USD_PER_MILLION | Для неизвестной модели | model default | Локальная оценка cached input |
BEEAGENT_OUTPUT_USD_PER_MILLION | Для неизвестной модели | model default | Локальная оценка output cost |
BEEAGENT_CACHE_WRITE_USD_PER_MILLION | Для неизвестной модели | model default | Локальная оценка cache write |
Локальный spend ledger является оценкой и не ограничивает фактический billing аккаунта.
Статус реальной AI-интеграции
GPT-5.4 mini была проверена через настоящий OpenAI API.
В первых шести внешних сценариях:
- четыре прошли полностью;
- один ответ модели был отклонён валидатором;
- в одном вопросе про весь план модель выбрала инструмент отдельной кампании вместо plan summary.
Ошибки сохранены в отчёте. Логика после этого была уточнена и проверена локально, но эти два исправленных сценария ещё не были повторно прогнаны через внешний API.
Первый внешний тест использовал 12 model calls с учётом tool continuations, около 47 630 input tokens и 2 568 output tokens. Локальная оценка расходов составила около $0.047.
Все исходы: отчёт реальной AI-интеграции.
При работающем приложении с уже рассчитанным планом:
# Только локальная проверка конфигурации, без обращения в OpenAI:
python tools/check_ai_connection.py
# Явный запуск шести платных сценариев с собственным ключом:
python tools/check_ai_connection.py --paid-smoke
Предложения не применяются автоматически. Успешный ответ настоящего API в браузере отдельно ещё не воспроизводился; HTTP-проверка и локальные протокольные тесты описаны в отчёте тестирования.
Покрытие требований кейса
| Требование | Реализация BeeAgent | Проверка |
|---|---|---|
Agent.act(env) работает | Самодостаточный конкурсный агент в agent.py | python tools/verify_submission.py |
| От 1 до 10 валидных кампаний | Solver выдаёт допустимые тарифы, каналы и фильтры | Submission verification и официальный прогон |
| Пилоты влияют на решение | Адаптивный цикл next_pilot / observe меняет оценки и планы | Официальный прогон, раздел Пилоты, unit tests |
| Соблюдение лимитов | Бюджет, контакты, пилоты и campaign caps учитываются в движке | Официальный scoring и resource checks |
Воспроизводимый submission.csv | Генерируется неизменённым скриптом организаторов в свежих процессах | python tools/verify_submission.py |
| Учёт неопределённости | Mean, variance, размер пилота и interval | Основания решения, tests |
| Адаптивная разведка | Следующий эксперимент зависит от наблюдений | Decision trace |
| Осмысленный канал | Стоимость и behavior канала участвуют в плане | Solver и channel comparison |
| Устойчивость | Сохранены официальные seeds 0-9 | local_eval.py --runs 10 |
| LLM в контуре решения | Grounded server tools вызывают настоящий planning engine | AI integration artifact |
Воспроизводимость
Основная команда проверки:
source .venv/bin/activate
python tools/verify_submission.py
Она проверяет:
- неизменность защищённых файлов организаторов;
- импорт
Agent; - официальный локальный прогон;
- бюджет, контакты и лимит пилотов;
- десять официальных seed-прогонов;
- повторную генерацию
submission.csvв свежих процессах; - одинаковый результат при разных
PYTHONHASHSEED; - отсутствие зависимости конкурсного пути от OpenAI;
- валидность количества кампаний, тарифов и каналов;
- заблокированную сеть во время конкурсной проверки.
Дополнительные проверки:
python -m unittest discover -s tests -v
npm --prefix frontend run build
node tools/check_ui_copy.mjs
node tools/test_presentation.mjs
python tools/check_clean_install.py
Финальная проверка из свежего GitHub-клона выполнена 23.09.2026 на macOS 15.1 arm64, Python 3.12.14, Node.js 20.19.5 и npm 10.8.2. Все обязательные команды завершились с кодом 0; UI проверен без API, конкурсный агент также запущен отдельно без OpenAI SDK и Node. Полный журнал команд и оставшиеся ограничения.
Уже выполнены 31 unit/protocol-тест, сборка, чистая установка и браузерные проверки на ширинах 1440, 1280 и 390 px. Проверены ручной сценарий без API, сравнение, явное применение, сохранение после перезагрузки и экспорт. Фактические результаты и границы проверки.
Фактические результаты на данных кейса
Эти значения относятся только к синтетической открытой среде кейса. Они не являются реальными показателями Beeline и не прогнозируют скрытое судейство.
| Проверка | Результат |
|---|---|
| Seed 42, net result | 2 658 548 у.е. |
| Forecast того же плана | 5 011 925 у.е. |
| Завышение forecast | 2 353 376 у.е. |
| Communication spend | 100 000 у.е. |
| Contacts | 10 988 |
| Pilots | 20 |
| Final campaigns | 7 |
| Seeds 0-9, median | 2 879 746 у.е. |
| Seeds 0-9, minimum | 2 399 590 у.е. |
| Seeds 0-9, positive | 10 / 10 |
Forecast остаётся существенно оптимистичным. BeeAgent показывает это ограничение явно и не выдаёт прогноз за гарантированный результат.
На этапе 4 численная политика beeagent-repeat-3 и submission сохранены побайтно. Выбор политики на этапе 3 проводился по заранее зафиксированному протоколу: сохранены 68 разработочных и 120 отложенных исходов. На отложенных официальных seed выбранная политика улучшила результат предыдущей версии, но уступила варианту с фиксированными пилотами. Во всех четырёх авторских стресс-мирах её медиана ухудшилась; при смене лучшего направления пять из пяти исходов отрицательны. Универсальная устойчивость не доказана. Полное сравнение.
Приватность и безопасность
- Исходные данные и scoring files организаторов не изменены.
- Полные строки клиентов и их ID не передаются в OpenAI.
- Ассистент получает агрегаты плана, выбранные основания и параметры тарифов.
- API key хранится только на backend.
- Ключ не коммитится, не возвращается API и не сохраняется в browser localStorage.
- AI не может применить план самостоятельно.
- Основная конкурсная проверка не требует внешнего API или личного аккаунта участника.
Известные ограничения
- Финальный
npm auditвыявил одну уязвимую dev-зависимость высокой серьёзности: Vite 7.1.7. Штатный./run.shвыполняет сборку и обслуживает готовые файлы Python-сервером, не запуская Vite dev server.npm audit --omit=devвернул 0 уязвимостей. Обновление инструмента разработки отложено за пределы freeze; подробности и источники. - Исторические переходы не доказывают причинность.
- Forecast не откалиброван и остаётся оптимистичным в открытой среде кейса.
- Portfolio optimization эвристический и не гарантирует глобальный optimum.
- ID клиентов из пилотной выборки недоступны агенту, поэтому часть overlap оценивается вероятностно.
- Позднему крупному решению может не хватить ресурса на повторный пилот.
- Эффекты скрытого судейства неизвестны.
- Нет реальной отправки кампаний, публичного хостинга, авторизации и production multi-user security.
- Safari, Firefox, физический телефон и полный screen-reader/WCAG audit не проверялись исчерпывающе.
- Два исправленных AI edge cases пока повторно проверены только локально.
Артефакты сдачи
Обязательные артефакты кейса:
agent.pysubmission.csvrequirements.txt
Репозиторий дополнительно содержит рабочий интерфейс, архитектуру, инструменты воспроизводимости и сохранённые доказательства проверок.
SHA-256 текущего submission.csv:
f3935486bd54ebe001b9aa54c1773d51fff91387b585c57c9f9542658502197f
Документация
docs/FINAL_QA.md- финальная проверка с чистого клона перед сдачейdocs/TESTING_STAGE4.md- актуальный отчёт тестированияdocs/PRODUCT_STAGE4.md- продуктовые и UX решенияdocs/ACCEPTANCE.md- карта приёмкиdocs/DEMO.md- сценарий демонстрацииdocs/AI_ASSISTANT.md- архитектура и ограничения ассистентаdocs/NUMERICAL_STAGE3.md- эксперимент численной политики и сохранённые результаты
BeeAgent превращает неопределённые тарифные возможности в объяснимый план кампаний, который маркетолог может проверить, оспорить и применить.
Авторы коммитов
История коммитов
- 2026-09-23 17:53Freeze BeeAgent submission after clean-clone final QAAlex
- 2026-09-23 17:41Update Russian README from final project briefAlex
- 2026-09-23 17:27Polish BeeAgent workspace and connect grounded GPT mini assistantAlex
- 2026-09-23 16:33Improve material-decision pilots and bind evidence to plan versionsAlex
- 2026-09-23 15:19feat: evolve BeeAgent workspace and grounded server assistantAlex
- 2026-09-23 14:28Build LEVRA offline decision engine and evidence-driven campaign workspaceAlex
Структура репозитория (290 файлов)
.env.example
.gitignore
AGENTS.md
PARTICIPANT_GUIDE.md
PARTICIPANT_GUIDE.pdf
README.md
START_HERE.md
STATE.md
agent.py
agent_template.py
backend/assistant.py
backend/identity.py
backend/local_config.py
backend/plans.py
backend/presentation.py
backend/server.py
customer_profile.csv
data/arpu_monthly.csv
data/change_tariff.csv
data/dict_tariff.csv
data/traffic.csv
docs/ACCEPTANCE.md
docs/AI_ASSISTANT.md
docs/BRAND_SOURCES.md
docs/BUILD_BRIEF.md
docs/BeeAgent_Prompt_02.md
docs/BeeAgent_Prompt_03.md
docs/DATA_AUDIT.md
docs/DEMO.md
docs/FINAL_QA.md
docs/NUMERICAL_REVIEW.md
docs/NUMERICAL_STAGE3.md
docs/ORIGINAL_CASE_WITH_RUBRIC.pdf
docs/ORIGINAL_MANIFEST.json
docs/PRODUCT_STAGE4.md
docs/PROMPT_01_BUILD.md
docs/STAGE2_VALIDATION_PROTOCOL.md
docs/STAGE3_VALIDATION_PROTOCOL.md
docs/TESTING_STAGE2.md
docs/TESTING_STAGE3.md
docs/TESTING_STAGE4.md
environment.py
feature_dictionary.csv
frontend/index.html
frontend/package-lock.json
frontend/package.json
frontend/public/brand/beeline.svg
frontend/src/AssistantPanel.tsx
frontend/src/DecisionEvidence.tsx
frontend/src/ScenarioComparison.tsx
frontend/src/main.tsx
frontend/src/presentation.tsx
frontend/src/style.css
frontend/src/workspace.css
frontend/tsconfig.json
frontend/vite.config.ts
local_eval.py
make_submission.py
mock_environment.py
reports/baseline_10_seeds.txt
reports/baseline_benchmark.json
reports/baseline_seed42.txt
reports/baseline_submission_generation.txt
reports/baseline_submission_seed42.csv
reports/data_audit.json
reports/data_audit_stdout.txt
reports/final/browser_checks.json
reports/final/check_clean_install.log
reports/final/clean-comparison.png
reports/final/clean-no-api.png
reports/final/clean-plan.png
reports/final/clean_clone.json
reports/final/clean_install.json
reports/final/clone_commit.log
reports/final/commands.json
reports/final/contest_only.json
reports/final/contest_only_0.log
reports/final/contest_only_1.log
reports/final/contest_only_2.log
reports/final/copy_lint.json
reports/final/copy_lint.log
reports/final/diff_check.log
reports/final/frontend_build.log
reports/final/git_clone.log
reports/final/github-readme-access.png
reports/final/hygiene.json
reports/final/launch.log
reports/final/local_eval.log
reports/final/local_eval_10.log
reports/final/make_submission.log
reports/final/mermaid_install.log
reports/final/node_version.log
reports/final/npm_audit.json
reports/final/npm_audit_production.json
reports/final/npm_ci.log
reports/final/npm_version.log
reports/final/pip_install.log
reports/final/presentation_tests.log
reports/final/python_version.log
reports/final/readme-mermaid.png
reports/final/source_checks.json
reports/final/unit_tests.log
reports/final/venv.log
reports/final/verification.json
reports/final/verification_raw.json
reports/final/verify_logs/agent_import.log
reports/final/verify_logs/local_eval.log
reports/final/verify_logs/local_eval_10.log
reports/final/verify_logs/originals.log
reports/final/verify_logs/originals_after.log
reports/final/verify_logs/submission_11.log
reports/final/verify_logs/submission_937.log
reports/final/verify_submission.log
reports/levra/api_smoke.json
reports/levra/audit_repair_ablation.json
reports/levra/clean_install.txt
reports/levra/clean_local_eval.txt
reports/levra/clean_tests.txt
reports/levra/comparison.json
reports/levra/comparison.txt
reports/levra/frontend_build.txt
reports/levra/latest_snapshot.json
reports/levra/local_eval.txt
reports/levra/originals.txt
reports/levra/reproducibility.json
reports/levra/reproducibility.txt
reports/levra/synthetic_stress.json
reports/levra/synthetic_stress.txt
reports/levra/ten_seeds.txt
reports/levra/tests.txt
reports/levra/ui/desktop.png
reports/levra/ui/mobile.png
reports/levra/ui/verification.json
reports/preparation_checks.json
reports/stage2/after/api_smoke.txt
reports/stage2/after/api_stage2.json
reports/stage2/after/api_stage2.txt
reports/stage2/after/artifact_checks.json
reports/stage2/after/frontend_build.txt
reports/stage2/after/local_eval.txt
reports/stage2/after/originals.txt
reports/stage2/after/package_lock.txt
reports/stage2/after/regression.json
reports/stage2/after/reproducibility.txt
reports/stage2/after/ten_seeds.txt
reports/stage2/after/tests.txt
reports/stage2/before/README.md
reports/stage2/before/STATE.md
reports/stage2/before/agent.py.txt
reports/stage2/before/api_smoke.json
reports/stage2/before/latest_snapshot.json
reports/stage2/before/local_eval.txt
reports/stage2/before/originals.txt
reports/stage2/before/reproducibility.json
reports/stage2/before/submission.csv
reports/stage2/before/ten_seeds.txt
reports/stage2/before/tests.txt
reports/stage2/forecast_audit.json
reports/stage2/forecast_audit.log
reports/stage2/forecast_diagnosis.json
reports/stage2/screenshots/assistant-390.png
reports/stage2/screenshots/assistant-cancel.png
reports/stage2/screenshots/assistant-no-api-1440.png
reports/stage2/screenshots/campaigns-1280.png
reports/stage2/screenshots/cancel-wait.png
reports/stage2/screenshots/first-run-empty-1280.png
reports/stage2/screenshots/first-run-loading.png
reports/stage2/screenshots/invalid-plan-390.png
reports/stage2/screenshots/overview-1440.png
reports/stage2/screenshots/overview-390.png
reports/stage2/screenshots/repair-comparison-1440.png
reports/stage3/ai_check.log
reports/stage3/ai_integration.json
reports/stage3/api_smoke.log
reports/stage3/api_stage3.json
reports/stage3/baseline/agent.py
reports/stage3/baseline/submission.csv
reports/stage3/baseline/validation_protocol.md
reports/stage3/benchmark_ui.json
reports/stage3/browser_checks.json
reports/stage3/browser_export.csv
reports/stage3/clean_install.json
reports/stage3/clean_install.log
reports/stage3/clean_install_initial.json
reports/stage3/decision_trace.json
reports/stage3/development.json
reports/stage3/development.jsonl
reports/stage3/development.log
reports/stage3/diagnosis_summary.txt
reports/stage3/forecast_diagnosis.json
reports/stage3/frontend_build.txt
reports/stage3/heldout.json
reports/stage3/heldout.jsonl
reports/stage3/heldout.log
reports/stage3/heldout_freeze.json
reports/stage3/integration_parity.json
reports/stage3/local_eval.txt
reports/stage3/local_eval_10.txt
reports/stage3/make_submission.txt
reports/stage3/originals.json
reports/stage3/registration.json
reports/stage3/release_check.log
reports/stage3/release_checks.json
reports/stage3/reproducibility.json
reports/stage3/screenshots/assistant-390.png
reports/stage3/screenshots/assistant-no-api-1440.png
reports/stage3/screenshots/compare-before-apply.png
reports/stage3/screenshots/grouped-checks.png
reports/stage3/screenshots/overview-1440.png
reports/stage3/screenshots/overview-390.png
reports/stage3/screenshots/repair-proposal.png
reports/stage3/screenshots/repeat-pilot-evidence.png
reports/stage3/screenshots/variant-restored.png
reports/stage3/selection.json
reports/stage3/unit_progress.log
reports/stage3/unit_tests.txt
reports/stage4/agent_import.log
reports/stage4/ai_integration.json
reports/stage4/ai_smoke.log
reports/stage4/baseline.json
reports/stage4/before.png
reports/stage4/browser_checks.json
reports/stage4/clean_install.json
reports/stage4/clean_install.log
reports/stage4/clean_install_before_mini.json
reports/stage4/clean_install_delta.json
reports/stage4/connect-mini.png
reports/stage4/copy_lint.json
reports/stage4/decision-evidence.png
reports/stage4/desktop-1280.png
reports/stage4/desktop-1440.png
reports/stage4/frontend_build.log
reports/stage4/http_checks.json
reports/stage4/local_eval.log
reports/stage4/local_eval_10.log
reports/stage4/mobile-390.png
reports/stage4/mobile-assistant.png
reports/stage4/no-api-scenario.png
reports/stage4/no-api.png
reports/stage4/originals.log
reports/stage4/originals_after.log
reports/stage4/pilot-decision.png
reports/stage4/presentation_tests.log
reports/stage4/release_checks.json
reports/stage4/responsive_checks.json
reports/stage4/scenario-before-apply.png
reports/stage4/status_after_browser.json
reports/stage4/submission_11.log
reports/stage4/submission_937.log
reports/stage4/unit_tests.log
reports/stage4/verification.json
reports/template_initial_local_eval.txt
reports/template_initial_ten_seeds.txt
requirements-server.txt
requirements.txt
run.sh
scoring_core.py
submission.csv
tariff_dictionary.csv
tests/test_assistant.py
tests/test_engine.py
tests/test_local_config.py
tests/test_mini.py
tests/test_presentation.py
tests/test_stage3.py
tools/audit_data.py
tools/audit_repair_benchmark.py
tools/benchmark_baseline.py
tools/benchmark_levra.py
tools/check_ai_connection.py
tools/check_clean_install.py
tools/check_release.py
tools/check_reproducibility.py
tools/check_ui_copy.mjs
tools/configure_ai.py
tools/diagnose_stage3.py
tools/forecast_audit.py
tools/forecast_diagnosis.py
tools/report_stage3.py
tools/select_stage3.py
tools/smoke_api.py
tools/smoke_stage2.py
tools/smoke_stage3.py
tools/stage3_variants.py
tools/stage3_worlds.py
tools/stress_levra.py
tools/test_presentation.mjs
tools/validate_stage3.py
tools/verify_originals.py
tools/verify_submission.py
Обсуждение 0 комментариев
Войдите, чтобы комментироватьПока нет комментариев — будьте первым.