О проекте
Команда: 50 Tenge
Кейс HackAlem.ai: Финансы — Freedom
Стадия: Доведённый продукт
Задача кейса: «Граф денег»: восстановить структуру организованной группы по сети транзакций (AML)
Суть
AML-инструмент для сети переводов из 2 248 клиентов и 81 seed. Назначает клиентам роли по правилам с объяснением, строит объяснимую очередь проверки (top-30), группы Louvain с оценкой устойчивости и Streamlit-экран аналитика с AI-помощником.
Как устроено
Пайплайн run.py берёт nodes/edges/transactions.parquet, проверяет согласованность данных и строит направленный граф. Считаются признаки: степени, суммы, pass_through, betweenness, PageRank, досягаемость от seed. Восемь упорядоченных правил назначают роль (consolidator, distributor, coordinator, transit, terminal, peripheral) с role_score. priority_score собирается из рангов объёма, betweenness, досягаемости от seed и степени. Кластеры Louvain строятся на неориентированной проекции, их устойчивость проверяется десятью повторами с индексом Жаккара. Отдельно ищутся временные паттерны, циклы и маршруты, есть сценарии удаления топ-N. Результаты выгружаются в CSV/JSON.
Ключевые решения
- Louvain
- betweenness centrality
- PageRank
- правила ролей по квантилям
- ранговый priority score
- устойчивость кластеров (Jaccard, 10 перезапусков)
- поиск циклов и маршрутов
- удаление топ-N против случайного
- graph AI-агент с ограниченными функциями
Особенности
Прозрачные формулы ролей и приоритета, все пороги сохраняются в run_metadata.json. Устойчивость групп проверяется повторами Louvain, спорные отнесения показываются явно. Сравнение удаления топ-N со случайным удалением показывает влияние узлов на сеть. Запуск одной командой make.
Стек
Python · Streamlit · Docker · Makefile · Parquet
Модели
OpenAI
Проект создан за 5 часов на финале хакатона HackAlem.ai (23 сентября 2026, Астана). Код — BAITC-Hacks/hack-67979f3c-50-tenge.
README
README.mdГраф денег — команда «50 Tenge»
Русский | English
Кого из 2 248 клиентов проверить первым и почему? «Граф денег» помогает банковскому AML-аналитику исследовать обезличенную сеть переводов: выдвигает гипотезы о ролях клиентов, находит группы и формирует объяснимую очередь проверки.
Проект создан для кейса HackAlem AI. Отправная точка — 81 seed-клиент из списка организаторов. Вместо ручного просмотра всей сети аналитик получает карточки с числами, причинами приоритета, связями и ограничениями данных.
Роли — гипотезы для проверки. Ни одна оценка не является вероятностью виновности.
Быстрый старт
Нужны Python 3.12 (рекомендуется) с поддержкой venv и make. На Linux/macOS или в WSL после клонирования достаточно одной команды:
git clone https://github.com/BAITC-Hacks/hack-67979f3c-50-tenge.git
cd hack-67979f3c-50-tenge
make
make создаёт .venv, устанавливает зависимости, рассчитывает все результаты и запускает интерфейс на http://localhost:8501. Активация окружения вручную не нужна. Первый запуск требует интернета для установки пакетов; повторные используют установленное окружение. При изменении requirements.txt или starter/requirements.txt зависимости устанавливаются заново. Остановить локальный сервер — Ctrl+C.
Три исходных parquet-файла должны находиться в data/. Для основного расчёта API-ключ, GPU и облако не нужны. Если Python 3.12 установлен отдельной командой, используйте make PYTHON=python3.12 при создании окружения. Другой порт: make PORT=8502.
| Команда | Действие |
|---|---|
make / make run | Подготовить окружение, пересчитать данные, запустить интерфейс |
make pipeline | Создать все CSV и JSON без запуска интерфейса |
make ui | Открыть интерфейс с уже рассчитанными результатами |
make test | Запустить тесты |
make setup | Только установить зависимости |
make help | Показать доступные команды |
Без Make
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
python run.py --data data --out out
python -m streamlit run viz/app.py
На Windows PowerShell создать окружение командой py -3.12 -m venv .venv, затем активировать через .venv\Scripts\Activate.ps1; остальные команды те же. Для Makefile на Windows используйте WSL.
После разовой установки одна команда python run.py --data data --out out пересчитывает все результаты независимо от интерфейса. Docker-вариант также запускается одной командой — make docker-up (см. ниже).
Что реализовано
- Проверка исходных данных и согласованности рёбер с транзакциями по парам, суммам и количествам.
- Полный направленный граф, включая клиентов без наблюдаемых связей.
- Шесть ролей по формальным правилам; у каждого клиента —
role_score, сработавшее правило и русское объяснение с числами. - Приоритет проверки с четырьмя отдельными вкладами и готовый top-30.
- Кластеризация, гипотезы о группах, внутренние суммы и направленные переводы между группами.
- Проверка устойчивости групп при десяти альтернативных случайных стартах: устойчивое ядро, спорное отнесение клиентов, сходство состава групп.
- Экран аналитика: поиск любого полного gid, фильтры всей выборки, карточка клиента, граф на один–два шага, таблицы переводов и состав группы.
- Выгрузка обязательных CSV, выбранных клиентов группы и метаданных запуска.
- Опциональный AI-помощник: объяснение карточки со ссылками на переданные факты и предложения, какие данные запросить дальше.
- Временные паттерны, объяснимые необычные профили, повторяющиеся маршруты и короткие циклы.
- Сценарии удаления топ-N с сопоставлением со случайным удалением.
- AI-агент с ограниченными функциями графа и локальный поиск общих получателей без API.
Как работает решение
- Подать данные. Поместить
nodes.parquet,edges.parquet,transactions.parquetвdata/и запуститьrun.py. - Получить расчёт. Пайплайн проверяет данные, строит граф, считает признаки, назначает роли, группы и приоритеты, сохраняет результаты в
out/. - Выбрать клиента. Открыть очередь проверки или ввести полный gid. Поиск работает по всем клиентам, независимо от фильтров очереди.
- Проверить основания. Вкладки «Схема связей», «Переводы», «Группа клиента» и «Расчёт и основания» показывают направление денег, метрики, пороги, причины роли и вклад каждого признака в приоритет.
- Сформировать следующий шаг. Прочитать ограничения, определить недостающие сведения, скачать CSV или справку помощника. Окончательный вывод остаётся за аналитиком.
Метрики, роли и пороги
Почему эти метрики
| Метрика | Для чего используется |
|---|---|
in_deg, out_deg | Число разных отправителей и получателей: признаки сбора и веерного распределения |
in_kzt, out_kzt | Объём наблюдаемых потоков: масштаб активности |
in_tx, out_tx, средние суммы | Различают один крупный перевод и много небольших; доступны в карточке/выгрузке |
pass_through = out_kzt / in_kzt | Сопоставимость входа и выхода как признак возможного транзита |
betweenness | Посредничество на кратчайших направленных путях; расстояние — число переходов, а не сумма перевода |
pagerank | Дополнительная оценка положения узла по направлению и суммам; напрямую в роли и приоритет не входит |
seed_reach_count, seed_distance | Число разных seed, достигающих узел за 1–4 направленных шага, и минимальная дистанция |
depth, truncated_by_depth, wcc_id | Глубина обхода, обрыв наблюдения и принадлежность к независимому фрагменту сети |
Степень — число контрагентов, количество транзакций — число отдельных переводов. Десять переводов одному получателю дают out_deg=1, out_tx=10.
Назначение ролей
Правила применяются сверху вниз, первое совпавшее определяет основную роль. non-seed означает клиента вне исходного списка. Q75 — 75-й процентиль положительных входящих сумм non-seed, Q95 — 95-й процентиль положительного betweenness по всем узлам. Квантили вычисляются заново линейной интерполяцией; пустая выборка выключает соответствующее правило.
| Порядок | Роль | Формальное условие |
|---|---|---|
| 1 | peripheral — недостаточно данных | Входящих и исходящих связей 0 |
| 2 | consolidator / peripheral на границе | При depth=4 и out_deg=0: consolidator для non-seed с in_deg≥3 и in_kzt≥Q75; иначе peripheral. Роль terminal запрещена |
| 3 | coordinator — связующий узел | Non-seed; есть вход и выход; seed_reach_count≥2; betweenness≥Q95 |
| 4 | consolidator — признаки консолидации | Non-seed; in_deg≥3; in_deg≥2×max(out_deg,1); in_kzt≥Q75 |
| 5 | distributor — признаки распределения | out_deg≥5; для non-seed дополнительно out_deg≥2×max(in_deg,1) |
| 6 | terminal — наблюдаемый конечный получатель | Non-seed; есть вход; out_deg=0; depth<4 |
| 7 | transit — признаки транзита | Non-seed; есть вход и выход; 0.7≤pass_through≤1.3 |
| 8 | peripheral — роль не определена | Остальные случаи |
На предоставленных данных: Q75 = 165 000 KZT, Q95 ≈ 0,00133618. Точные значения сохраняются в out/run_metadata.json.
role_score описывает силу признаков с учётом ограничений. Пусть E(x,t)=clip((x/t−1)/2,0,1), где clip ограничивает число диапазоном 0..1:
| Роль | Формула role_score |
|---|---|
| consolidator | 0.55 + 0.15×E(in_deg,3) + 0.15×E(in_kzt,Q75); на обрыве минус 0.15 |
| distributor | 0.55 + 0.30×E(out_deg,5) |
| coordinator | 0.45 + 0.15×E(betweenness,Q95) + 0.15×E(seed_reach_count,2) |
| transit | 0.45 + 0.20×clip(1−abs(pass_through−1)/0.3,0,1) |
| terminal | 0.55 |
| peripheral | 0.10 для изолята, 0.15 для неопределённой границы, 0.20 для остальных |
Пороговые значения и коэффициенты — объяснимые эвристики команды, не результат обучения или статистической калибровки. Подробности: правила ролей.
Приоритет и группы
priority_score = 0.35×P(объём) + 0.30×P(betweenness)
               + 0.20×min(seed_reach_count/3, 1) + 0.15×P(степень)
P — средний ранг среди положительных значений, делённый на их количество; нулю соответствует 0. Для seed объём = out_kzt, степень = out_deg; для остальных объём = max(in_kzt,out_kzt), степень = in_deg+out_deg. Изолят получает приоритет 0.
Рейтинг сортируется по убыванию score, при равенстве — по gid. Если seed составляют больше трети исходного top-30, итоговый список строится среди non-seed. В текущем результате seed — 4 из 30, поэтому фильтрация не включается. role_score не умножается на приоритет: неопределённый узел тоже может заслуживать проверки.
Кластеры вычисляются Louvain внутри каждой слабосвязной компоненты на неориентированной проекции: встречные суммы складываются. Основные параметры: resolution=1.0, seed=42. Роли, приоритет и суммы потоков сохраняют направление исходного графа.
Десять повторов с другими seed алгоритма оценивают повторяемость групп. Для узла статус core означает сохранение отнесения не менее чем в 80% повторов; сходство состава группы измеряется индексом Жаккара. Это устойчивость алгоритма, не доказательство правильности группы. Экспериментальное согласованное разбиение сравнивается в метаданных и не заменяет основной cluster_id. Формулы и ограничения: кластеры и приоритет.
Что получается на выходе
| Файл | Содержание |
|---|---|
out/nodes_roles.csv | 2 248 строк: каждый gid, роль, role_score, группа, приоритет, evidence до 200 символов; дополнительные метрики и устойчивость отнесения |
out/clusters.csv | Строка на группу: размер, число seed, внутренний оборот, ключевые gid, гипотеза и диагностика устойчивости |
out/top_nodes.csv | 30 клиентов: ранг, gid, роль, приоритет и численное обоснование |
out/temporal_patterns.json | Дневная активность, временные признаки, повторяющиеся суммы и сравнение профиля по колену |
out/network_patterns.json | Маршруты, циклы и сценарии удаления узлов |
out/run_metadata.json | Пороги ролей, версии библиотек, параметры и диагностика кластеризации, длительность расчёта |
Обязательные колонки сохранены:
nodes_roles: gid, role, role_score, cluster_id, priority_score, evidence
clusters:    cluster_id, n_nodes, n_seed, sum_kzt_internal, top_gids, hypothesis
top_nodes:   rank, gid, role, priority_score, why
В CSV идентификаторы сохраняются как int64, в браузере передаются строками. При открытии в табличном редакторе импортируйте gid как текст: округление длинного номера ломает поиск.
out/ генерируется и исключён из git. Для сдачи приложить три CSV отдельно, вместе с диаграммой SVG, репозиторием и демонстрацией. Повторный запуск перезаписывает результаты.
Архитектура
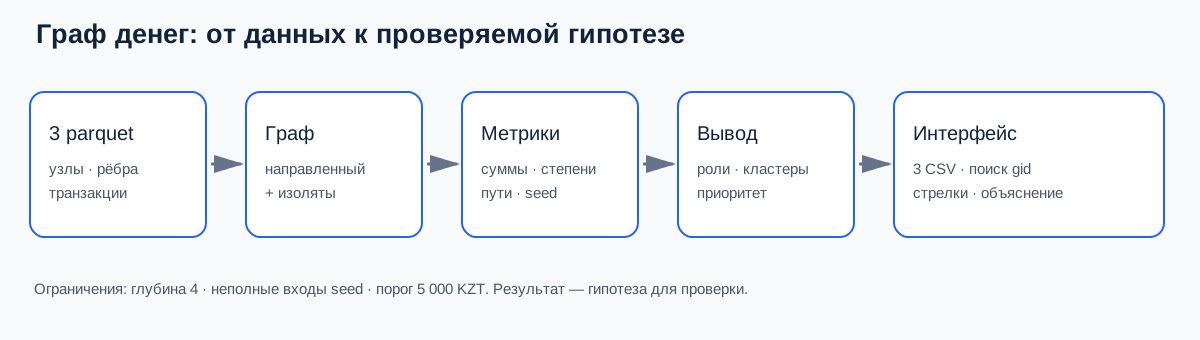
data/*.parquet
  → io.py: загрузка и проверки
  → graph.py: полный nx.DiGraph
  → features.py + seeds.py: признаки и достижимость
  → roles.py: роль, score, evidence
  → clusters.py + stability.py: группы и устойчивость
  → priority.py: очередь проверки
  → outputs.py: три CSV + run.py: метаданные
  → viz/app.py: поиск, карточка, граф, переводы и группы
       ↳ ai_assistant.py / ai_transport.py: опциональное объяснение через API
       ↳ graph_agent.py: ограниченные инструменты графа
  → temporal.py / routes.py → дополнительные JSON → bonus_panels.py
run.py связывает расчётные модули. Streamlit читает готовые CSV, исходные рёбра и метаданные; взаимодействие с экраном не запускает весь пайплайн заново. Тесты находятся в tests/, подробные аналитические правила — в docs/. Исходные data/ и starter/ не изменяются.
Технологии и AI
| Область | Технологии |
|---|---|
| Язык и таблицы | Python, pandas, NumPy, PyArrow / Parquet |
| Анализ графа | NetworkX, SciPy; PageRank, betweenness, BFS, Louvain |
| Экран | Streamlit, PyVis / vis-network, встроенные JS-ресурсы графа |
| Проверки | pytest, интеграционные CLI-тесты, Streamlit AppTest |
| Упаковка | Python venv, Make, Docker, Docker Compose |
| Опциональный помощник | OpenAI Responses API; модель по умолчанию в коде — gpt-4.1-mini, настраивается через OPENAI_MODEL |
Обучение модели не требуется. Роли, кластеры и приоритет вычисляются графовыми алгоритмами и правилами. Размеченных правильных ролей в данных нет. LLM объясняет рассчитанные факты и выбирает разрешённые функции поиска по графу; оценки и CSV не меняет.
Подключение помощника — необязательно
Создать локальный .env в корне проекта:
OPENAI_API_KEY=ваш_ключ
OPENAI_MODEL=gpt-4.1-mini
.env исключён из git. Настройки из окружения имеют приоритет над файлом. Для Docker Compose эти переменные передаются сервису dashboard.
Во вкладке «Помощник» выбрать вопрос и нажать «Получить объяснение». Только это действие отправляет в OpenAI вопрос, рассчитанные показатели выбранного клиента и до десяти крупнейших связей каждого направления. Контекст можно просмотреть до отправки. Нужны интернет и доступ к выбранной модели через API; запросы могут быть платными.
Ответ проверяется по структуре и допустимым ссылкам на факты, но это не гарантирует истинность каждого предложения: текст помечен как черновик для аналитика. Повторный показ сохранённого ответа в сессии не вызывает новый запрос. Без API доступны расчёты, карточки, граф и локальные факты помощника. Запросы не обогащают исходные данные внешними сведениями о клиентах.
Во вкладке «Помощник → Задать вопрос по сети» отдельный агент вызывает разрешённые функции графа: карточка клиента, общие получатели от всех указанных источников, направленный путь и лидеры выбранной группы. Максимум три API-запроса и шесть локальных операций на вопрос. Результаты операций и ссылки на клиентов показаны рядом с ответом. Число возвращаемых клиентов ограничено 20, глубина — четырьмя шагами. Поиск общих получателей доступен также локально без AI и ключа. См. метод и ограничения агента.
Дополнительный анализ
Обычная команда запуска также создаёт out/temporal_patterns.json и
out/network_patterns.json. В nodes_roles.csv добавляются временные счётчики,
процентили по колену и текстовые основания. Основные роли и приоритет не меняются.
- Активность клиента: график дневных потоков, вход и последующий выход через один–два дня, синхронные поступления, всплески, равные суммы и необычный профиль относительно того же колена. Формулы.
- Маршруты и циклы: повторяющиеся A→B→C с временными примерами, направленные циклы длины два–три. Выдача — первые 100 каждого типа с указанием общего числа; поиск для клиента фильтрует этот сохранённый набор, а не все маршруты графа.
- Уязвимость сети: удаление топ-1/3/5/10/20 по основному рейтингу, размер крупнейшей оставшейся части, фрагментация исходной компоненты и сравнение с двадцатью случайными удалениями того же размера. Описание.
Временные совпадения и циклы не доказывают движение тех же денег. Повтор суммы не доказывает дробление, а операции ниже 5 000 ₸ невидимы. Удаление узлов — сценарий изменения наблюдаемого графа, не прогноз прекращения деятельности. Пороговые правила задокументированы; отдельное ML-обучение не требуется.
Последний локальный полный расчёт с бонусами: 4.41 с, 2 248 клиентов, 107 групп, top-30. Найдено 112 повторяющихся маршрутов и 218 коротких циклов. Новая версия AI-агента проверена с подставными ответами API; живой запрос в финальной проверке не выполнялся. Экран дополнительного анализа проверен через Streamlit AppTest и в Chrome.
Очередь сборщиков и дополнительные признаки
Кнопка «Открыть очередь сборщиков» над основной очередью сбрасывает поиск и фильтры и показывает всех клиентов с основной ролью consolidator (70 в текущей выборке). Порядок задаёт существующий priority_score; официальный top-30 не меняется. Это сбор наблюдаемых поступлений, а не доказательство удержания средств на счёте.
Карточка показывает дополнительные совпавшие правила до выбора основной роли.
Например, связующий узел может одновременно иметь признаки распределения.
Условия берутся из общей функции pipeline.roles.role_candidates,
используемой назначением ролей. Основная роль сохраняет документированный
приоритет правил; дополнительные признаки не означают независимые доказательства.
Чувствительность приоритета к весам
Во вкладке «Расчёт и основания» доступна диагностика восьми сценариев: каждый из четырёх весов отдельно умножается на 0,8 и 1,2, затем все веса нормируются до суммы 1. Каждый сценарий заново применяет документированное правило отбора seed. Основной рейтинг и три CSV не изменяются.
На предоставленной выборке сохраняется 28–30 из 30 исходных участников приоритетного списка. Для каждого клиента показаны число попаданий в top-30 и диапазон места в общей очереди. Это чувствительность к выбранным настройкам, не оценка точности обнаружения. Все веса одновременно, пропуски данных и пороги ролей в этом эксперименте не варьируются.
Результат хранится в run_metadata.json → priority_sensitivity.
Полный расчёт с диагностикой занял 4,70 с. Следующий этап проверки качества —
экспертная оценка top-30 и случайной выборки, разбор ложных срабатываний и
измерение времени работы аналитика. Без размеченных расследований точность
ролей и вероятность нарушения не установлены.
Проверка перед сдачей
В отдельной копии без .env, старых результатов и установленного окружения
выполнена установка по инструкции выше. python -m pip check не выявил
конфликтов. Полный набор проверок:
python -m pytest tests -q
Результат: 157 passed. Проверены расчёты, контракты CSV, поиск и фильтры, изоляты и граница обхода, карточки, группы, бонусные маршруты, циклы, сценарии удаления и локальный поиск общих получателей. Тесты AI используют подставные ответы и не расходуют API-кредиты.
Два запуска в одном чистом окружении дали побайтово одинаковые три CSV
и оба дополнительных JSON-отчёта. Метаданные времени запуска могут отличаться.
Python 3.9.6: повторный расчёт 4.41 с; Docker с Python 3.12: 2.92 с
(без времени установки зависимостей и сборки образа). В обоих случаях —
2 248 клиентов, 107 групп и top-30. Совпадение файлов между разными версиями
библиотек не гарантируется; версии записываются в run_metadata.json.
В Chrome проверены загрузка карточки, отрисовка графа и переход к маршрутам и циклам без ошибок приложения. Исправлена ошибка форматирования списков маршрутов при повторном взаимодействии. Полный сценарий выбора клиента и фильтрации дополнительно покрыт семью тестами Streamlit AppTest.
Альтернативный запуск через Docker
Нужны работающий Docker Engine, Docker Compose и Buildx для сборки образа. При установленном make:
make docker-up
Команда сначала рассчитывает данные и только после успешного расчёта запускает интерфейс в фоне. Python на компьютере не требуется. Остановка — make docker-down, повторный расчёт без интерфейса — make docker-pipeline.
Без Make:
# От исходных parquet до трёх CSV:
docker compose run --build --rm pipeline

# Открыть интерфейс после расчёта:
docker compose up --build -d dashboard
Адрес: http://localhost:8501. Данные подключаются только для чтения; результаты остаются в локальной out/. Остановить интерфейс:
docker compose down
Если сборка сообщает об отсутствующем docker-buildx, установите Buildx для своей установки Docker либо используйте Python-запуск выше. Для пересчёта данных используется сервис pipeline; сам dashboard только читает результаты.
Данные и интеграции
Единственный источник расчётных данных — обезличенная выгрузка организаторов за 1–31 июля 2026.
| Файл | Строк | Поля |
|---|---|---|
data/nodes.parquet | 2 248 | gid, depth, is_seed |
data/edges.parquet | 3 119 | src, dst, sum_kzt, n_tx, depth |
data/transactions.parquet | 4 840 | src, dst, date, sum_kzt |
Граф собран по исходящим переводам от 81 seed до глубины 4, минимальная видимая транзакция — 5 000 KZT. В полном графе 35 слабосвязных компонент: 16 с рёбрами и 19 изолятов. Транзакции используются для проверки агрегатов и дополнительного временного анализа; временные закономерности основную роль не изменяют.
Нет интеграции с банковскими системами, базами персональных данных и внешним обогащением. Единственный опциональный внешний сервис — OpenAI API для объяснения карточки и выбора ограниченных функций графа. Исходные данные предоставлены для хакатона; gid — синтетические идентификаторы.
Ограничения и масштабирование
- Охват ограничен. Не видны другие банки, периоды, остатки и переводы ниже 5 000 KZT. Полный баланс клиента восстановить нельзя.
- Глубина 4 — граница данных. Отсутствие исходящих там не доказывает удержание средств. Входящие seed особенно неполны; они не определяют роль seed.
- Связи не доказывают происхождение денег. Совпадение сумм или путь от seed не устанавливает движение тех же средств. Coordinator — связующий узел по структуре, не установленный организатор.
- Нет ground truth. Пороги и веса эвристические; accuracy, вероятность нарушения и доказанная правильность групп не заявляются. Все метрики интерпретируются в пределах выборки.
- Рейтинг смещён к крупной компоненте. Все текущие top-30 находятся в ней. Фильтры полной таблицы позволяют исследовать другие группы и клиентов за пределами top-30.
- Устойчивость проверена ограниченно. Десять стартов Louvain при фиксированных данных и resolution не моделируют пропуски выгрузки. Экспериментальное согласованное разбиение не является независимой оценкой качества.
- Экран ограничивает окружение до 200 узлов. Число скрытых узлов показывается; расчёт использует всю сеть. Инструмент рассчитан на локальный анализ, без многопользовательской авторизации и промышленной банковской интеграции.
- AI может ошибаться. Помощник видит выбранную карточку; графовый агент — ограниченные результаты разрешённых запросов. Проверки формата и ссылок не заменяют проверку выводов человеком.
Масштабирование до миллиона узлов
Текущая реализация рассчитана на предоставленную выгрузку; время для миллиона узлов не измерялось. Для такого объёма необходимо:
- Хранить рёбра и признаки в колонночном хранилище и обрабатывать транзакции порциями по дате/клиенту; использовать компактную CSR-проекцию вместо объектов Python для каждого узла и ребра.
- Заменить точный betweenness приближением с фиксированной выборкой источников; графовые расчёты перенести в компилируемую реализацию, проверив совпадение семантики направлений, весов и изолятов.
- Повторные кластеризации запускать фоновыми заданиями. Не строить плотную матрицу всех пар; измерять стабильность на согласованной выборке запусков.
- Ограничивать маршруты длиной, датами и выбранным окружением. Полный перебор всех маршрутов не масштабируется; для дневных связей нужны индексы.
- Симуляции удаления узлов выполнять отдельным заданием, с явным бюджетом числа сценариев и сравнений со случайным удалением.
- Отдавать интерфейсу страницы таблиц и ограниченные окружения из индекса. AI получает только результаты ограниченных запросов, не весь граф.
Объём памяти и время оцениваются по числу рёбер, транзакций и распределению степеней, а не только числу узлов. Новую реализацию нужно сравнить на малой выборке с текущими формулами и отдельно измерить производительность.
Развёрнутая версия и материалы сдачи
Публичной deployed-версии пока нет. Рабочий вариант запускается локально по инструкции выше; localhost:8501 — адрес на машине запуска, не публичная ссылка.
- Демо с бонусными сценариями.
- Временные признаки, маршруты и уязвимость сети, AI-запросы.
- Полное ТЗ.
- Критерии ролей и score.
- Кластеризация, приоритет и устойчивость.
- Диаграмма для слайда — SVG, Mermaid.
- Выгрузки для передачи жюри:
out/nodes_roles.csv,out/clusters.csv,out/top_nodes.csv.
Авторы коммитов
История коммитов
- 2026-09-23 18:02docs: update demo to latest interface and verify recordingYershuak Soltanbai
- 2026-09-23 17:51feat: strengthen cluster hypotheses and verify final release workflowaigera
- 2026-09-23 17:39docs: record demo video and validation resultsYershuak Soltanbai
- 2026-09-23 17:38feat: add readable money flow overview and improve graph navigationaigera
- 2026-09-23 17:33Plan.mdwoop1e
- 2026-09-23 17:29feat: add priority sensitivity and collector review workflowaigera
- 2026-09-23 17:17docs: sync English README verification resultsaigera
- 2026-09-23 17:16fix: stabilize route selectors and verify release workflowaigera
Все коммиты (36)
- 2026-09-23 17:15Makefile + Readmewoop1e
- 2026-09-23 17:07feat: add temporal patterns, network resilience and graph AI agentaigera
- 2026-09-23 17:04README.mdwoop1e
- 2026-09-23 17:02docs: note NVIDIA Build verification blockerYershuak Soltanbai
- 2026-09-23 16:58docs: document solution, setup and jury demo in READMEwoop1e
- 2026-09-23 16:49Readmewoop1e
- 2026-09-23 16:46feat: assess cluster stability and expose disputed membershipsaigera
- 2026-09-23 16:35fix: align assistant response validation and show safe error reasonsaigera
- 2026-09-23 16:33feat: polish analyst UI and add grounded OpenAI explanationsaigera
- 2026-09-23 16:09Add in-app help and bulk group selectionYershuak Soltanbai
- 2026-09-23 15:56feat: simplify analyst dashboard and explain client prioritiesaigera
- 2026-09-23 15:46Document verified Docker and browser demoYershuak Soltanbai
- 2026-09-23 15:38Add cluster colors to connected analyst graphYershuak Soltanbai
- 2026-09-23 15:30Show all ranked nodes and keep graph neighborhoods connectedYershuak Soltanbai
- 2026-09-23 15:24Integrate streams A and B into verified demo flowYershuak Soltanbai
- 2026-09-23 15:22test(A): verify full pipeline integration and finalize handoffwoop1e
- 2026-09-23 15:12fix: preserve client identifiers and document ranking auditaigera
- 2026-09-23 15:10feat(A): implement graph features and explainable node roleswoop1e
- 2026-09-23 15:02feat: implement stream B graph ranking and validated exportsaigera
- 2026-09-23 14:58Build stream C pipeline entrypoint and analyst dashboardYershuak Soltanbai
- 2026-09-23 14:48docs: restore Plan.md title lost in previous commitaigera
- 2026-09-23 14:47docs: add ТЗ copy, balance workload across A/B/C, tighten agent rulesaigera
- 2026-09-23 14:36docs: refine team workflow and analytics implementation planaigera
- 2026-09-23 14:28Add Docker Compose setup for starter pipelineYershuak Soltanbai
- 2026-09-23 14:26plan.mdwoop1e
- 2026-09-23 14:09Add solution diagram artifact and demo cross-check note to AGENTS.mdaigera
- 2026-09-23 14:03Add case data and organizer-provided starter codeaigera
- 2026-09-23 14:03Add AGENTS.md with case constraints and module contract for Codexaigera
Структура репозитория (64 файлов)
.dockerignore
.gitignore
.streamlit/config.toml
AGENTS.md
Dockerfile
Makefile
README.en.md
README.md
compose.yaml
data/edges.parquet
data/nodes.parquet
data/transactions.parquet
docs/Plan.md
docs/cluster-hypotheses.md
docs/demo.md
docs/graph-agent.md
docs/ranking.md
docs/release-check.md
docs/roles.md
docs/routes.md
docs/scheme.md
docs/scheme.svg
docs/status-a.md
docs/status-b.md
docs/status-c.md
docs/temporal.md
docs/tz.md
pipeline/__init__.py
pipeline/clusters.py
pipeline/features.py
pipeline/graph.py
pipeline/io.py
pipeline/outputs.py
pipeline/priority.py
pipeline/priority_sensitivity.py
pipeline/roles.py
pipeline/routes.py
pipeline/seeds.py
pipeline/stability.py
pipeline/temporal.py
requirements.lock.txt
requirements.txt
run.py
scripts/build_submission.py
scripts/check_browser.cjs
scripts/check_live_ai.py
starter/README.md
starter/requirements.txt
starter/starter.py
tests/test_ai_transport.py
tests/test_bonus_analysis.py
tests/test_clusters_priority.py
tests/test_graph_agent.py
tests/test_io.py
tests/test_outputs.py
tests/test_roles.py
tests/test_ui.py
viz/ai_assistant.py
viz/ai_transport.py
viz/app.py
viz/bonus_panels.py
viz/cluster_quality.py
viz/flow_overview.py
viz/graph_agent.py
Обсуждение 0 комментариев
Войдите, чтобы комментироватьПока нет комментариев — будьте первым.