О проекте
Команда: Lahmut Group
Кейс HackAlem.ai: Инновации — Самрук-Казына
Стадия: Доведённый продукт
Задача кейса: «Хаттама»: протокол и поручения по аудиозаписи совещания (каз./рус./смешанная речь)
Суть
Система собирает из аудиозаписи совещания на русском, казахском или смешанном языке проект протокола: краткий итог, реплики по голосам с таймкодами и поручения с исполнителями и сроками. Секретарь проверяет каждое поручение по исходным репликам, утверждает протокол, выгружает DOCX и рассылает поручения через Telegram.
Как устроено
React загружает аудио, FastAPI ставит задачу в очередь (SQLite). Дальше идёт локальный ML-конвейер на GPU: транскрипция Whisper large-v3, диаризация pyannote Community-1, извлечение summary и поручений через Ollama Qwen3 (8B, затем профиль 32B) с проверкой оснований по репликам. Статусы проходят queued → transcribing → diarizing → extracting → review_ready. Человек правит и утверждает протокол, сохраняется снимок версии, экспортируется DOCX. Telegram-бот присылает назначение и принимает статус «Выполнено».
Ключевые решения
- Whisper large-v3
- pyannote Community-1 diarization
- Ollama local LLM
- evidence grounding поручений
- VAD
- human-in-the-loop approval
- DOCX export
- Telegram bot
Метрики
Запись №1: 274,25 с аудио обработаны за 42,4 с (30 сегментов, 10 поручений); №2: 206 с за 33,6 с (32 сегмента, 8 поручений); 88 backend-тестов, 35 Playwright-сценариев
Особенности
ASR, диаризация и LLM работают полностью локально, внешних API нет. Каждое поручение привязано к подтверждающей реплике. Команда честно разделяет прогоны 8B и 32B и публикует PDF с реальными ошибками распознавания рядом с эталоном организаторов. Есть скрипты оценки казахского ASR и сравнения ASR/VAD.
Стек
Python · FastAPI · SQLite · React · TypeScript · Vite · Playwright · systemd · NVIDIA L40S (Brev) · Telegram Bot API
Модели
Whisper large-v3 · pyannote Community-1 · Qwen3:8b (Ollama) · Qwen3 32B
Проект создан за 5 часов на финале хакатона HackAlem.ai (23 сентября 2026, Астана). Код — BAITC-Hacks/hack-b112b722-lahmut-group.
README
README.md
Запись → расшифровка → поручения → проверка → утверждённый документ
Запустить · Открыть PDF · Пример распознавания · Результаты ML · Архитектура · Показать жюри · Соответствие ТЗ
📄 Открыть PDF из реального серверного прогона — 4 страницы: итог встречи, реплики с голосами и временем, 10 поручений. Демонстрационный черновик, не утверждённый протокол.
До защиты осталась минута? Сценарий показа на 60 секунд — PDF, скриншот, готовые тезисы и ответы на вопросы; доступно без запуска GPU.
Совещание заканчивается. Ответственность остаётся.
После встречи нужно восстановить, что решили, кто отвечает и к какому сроку. На смешанной русско-казахской записи к этому добавляются смены языка, неясные имена и относительные сроки. Ошибка в одном поле превращается в чужое поручение или выдуманную дату.
Хаттама превращает запись или текст встречи в проект протокола, который можно проверить по исходным репликам. Секретарь уточняет исполнителей и сроки, сохраняет правки и утверждает документ. Команда получает DOCX, реестр поручений и локальные напоминания.
Интерфейс включает обзор встреч и сроков, светлую и тёмную темы, поиск и закреплённую панель проверки. Дополнительный Telegram-канал связывает участника с ботом, доставляет назначения после утверждения и возвращает статус «Выполнено». Он выключен по умолчанию; настройка и правила передачи данных.
| Для секретаря | Для руководителя | Для команды |
|---|---|---|
| Расшифровка и проект поручений вместо чистого листа | У каждой задачи есть подтверждающие реплики | Исполнитель, срок и статус собраны в реестре |
| Переход от поручения к месту в записи | Неясные поля явно требуют проверки | Утверждённая версия сохраняется отдельно |
Принцип продукта: модель готовит проект, человек подтверждает результат.
review_readyозначает готовность к проверке, а не автоматически достоверный протокол.
Приложение в работе
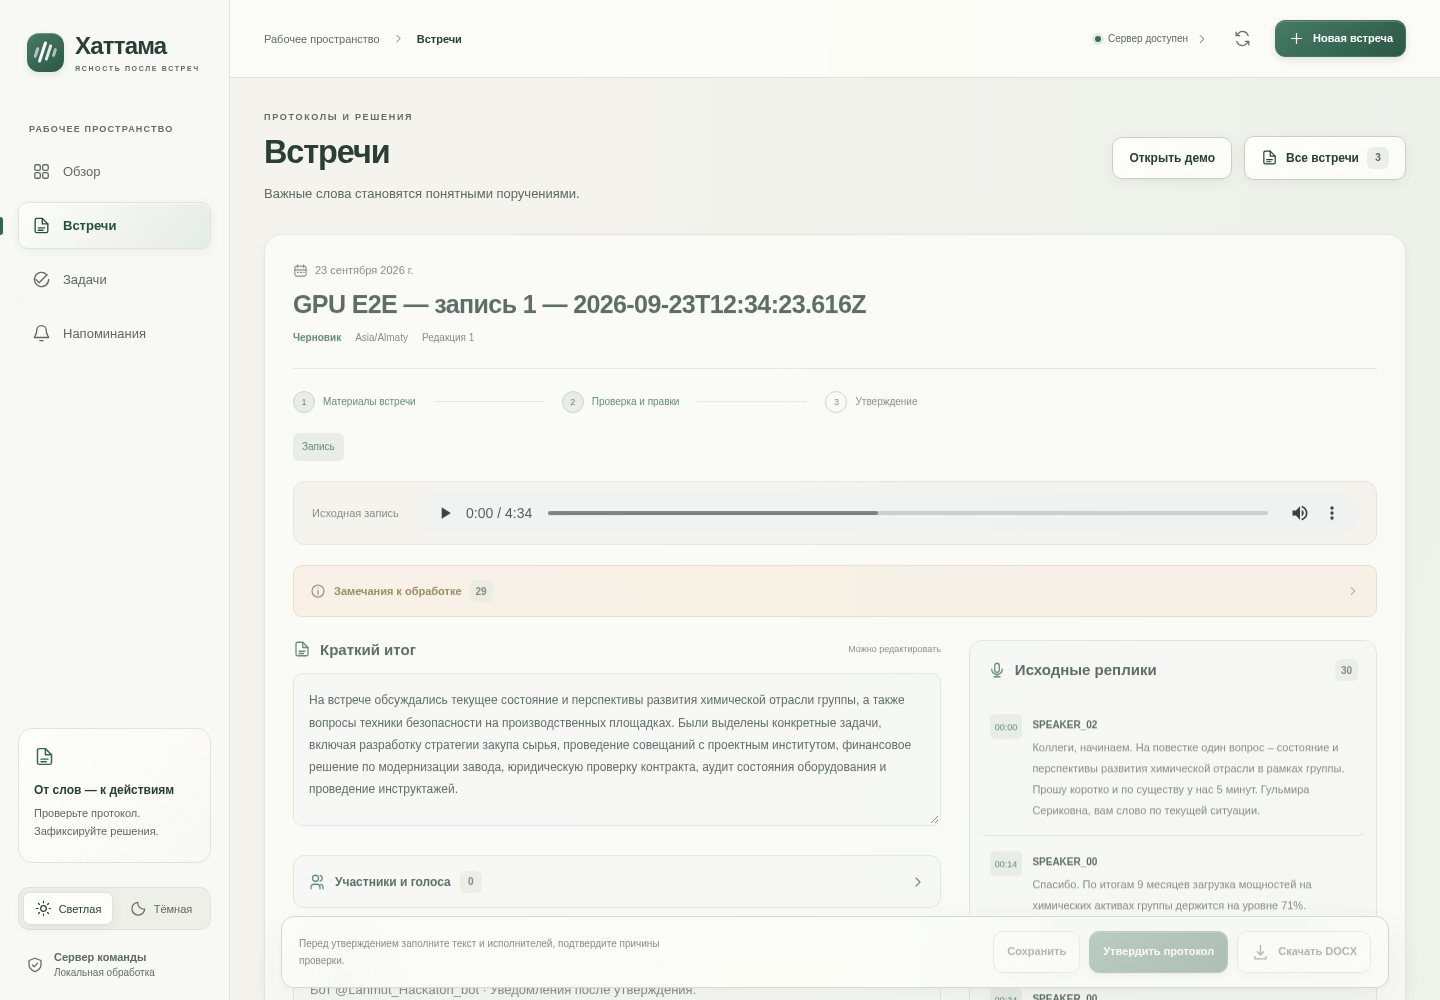
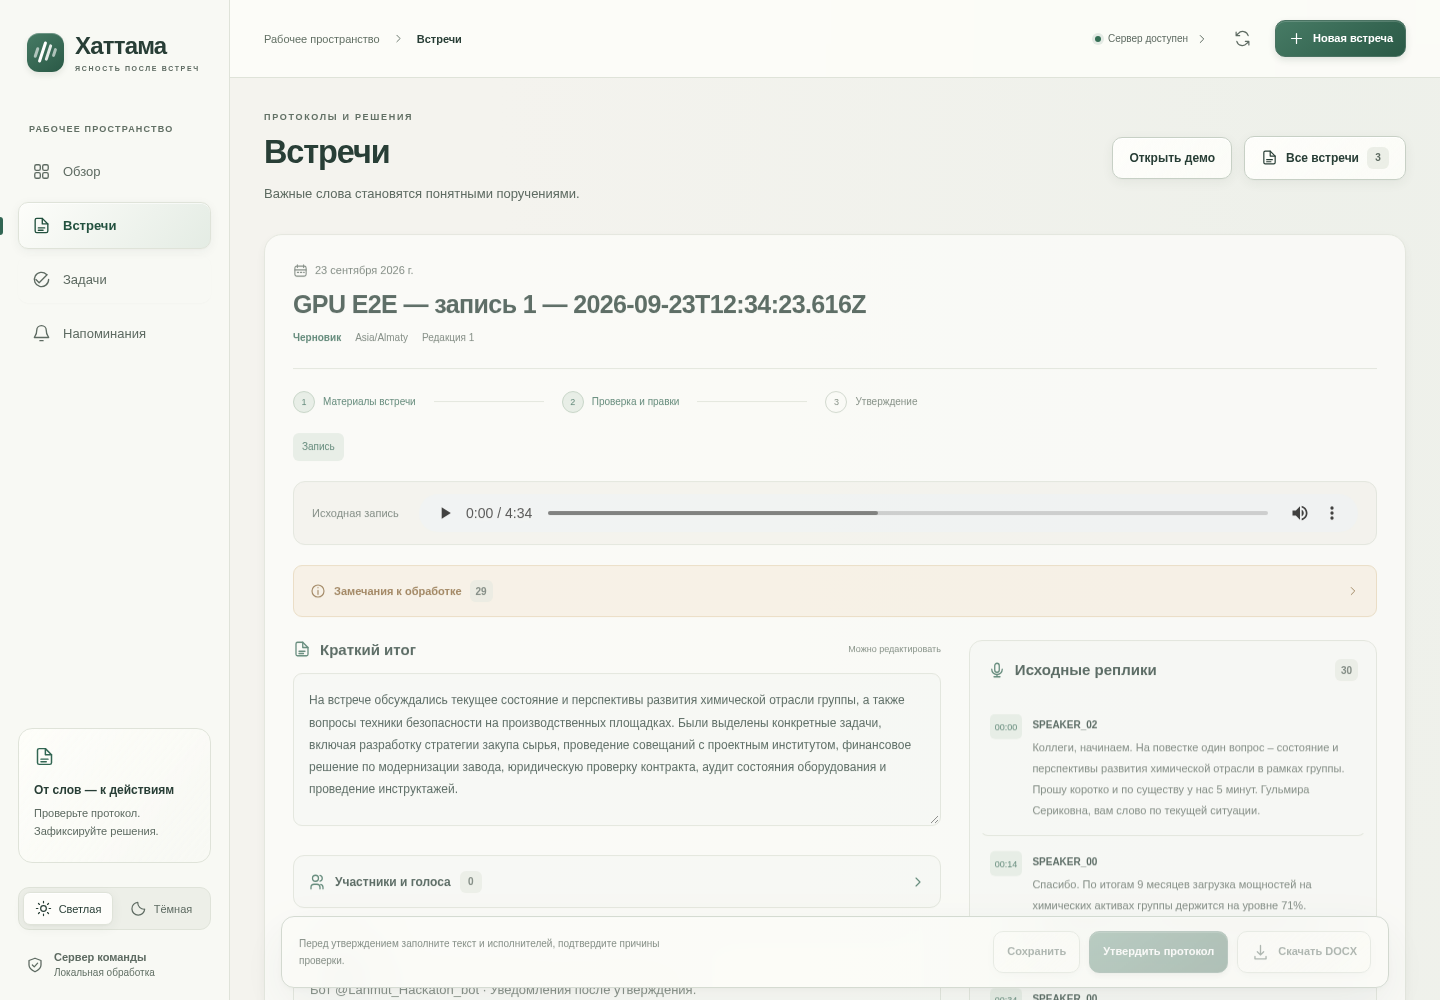
Проверка протокола рядом с исходными репликами. Запись, краткий итог, участники и замечания доступны на одном экране; перед утверждением спорные поля нужно проверить.
Реестр поручений · тёмная тема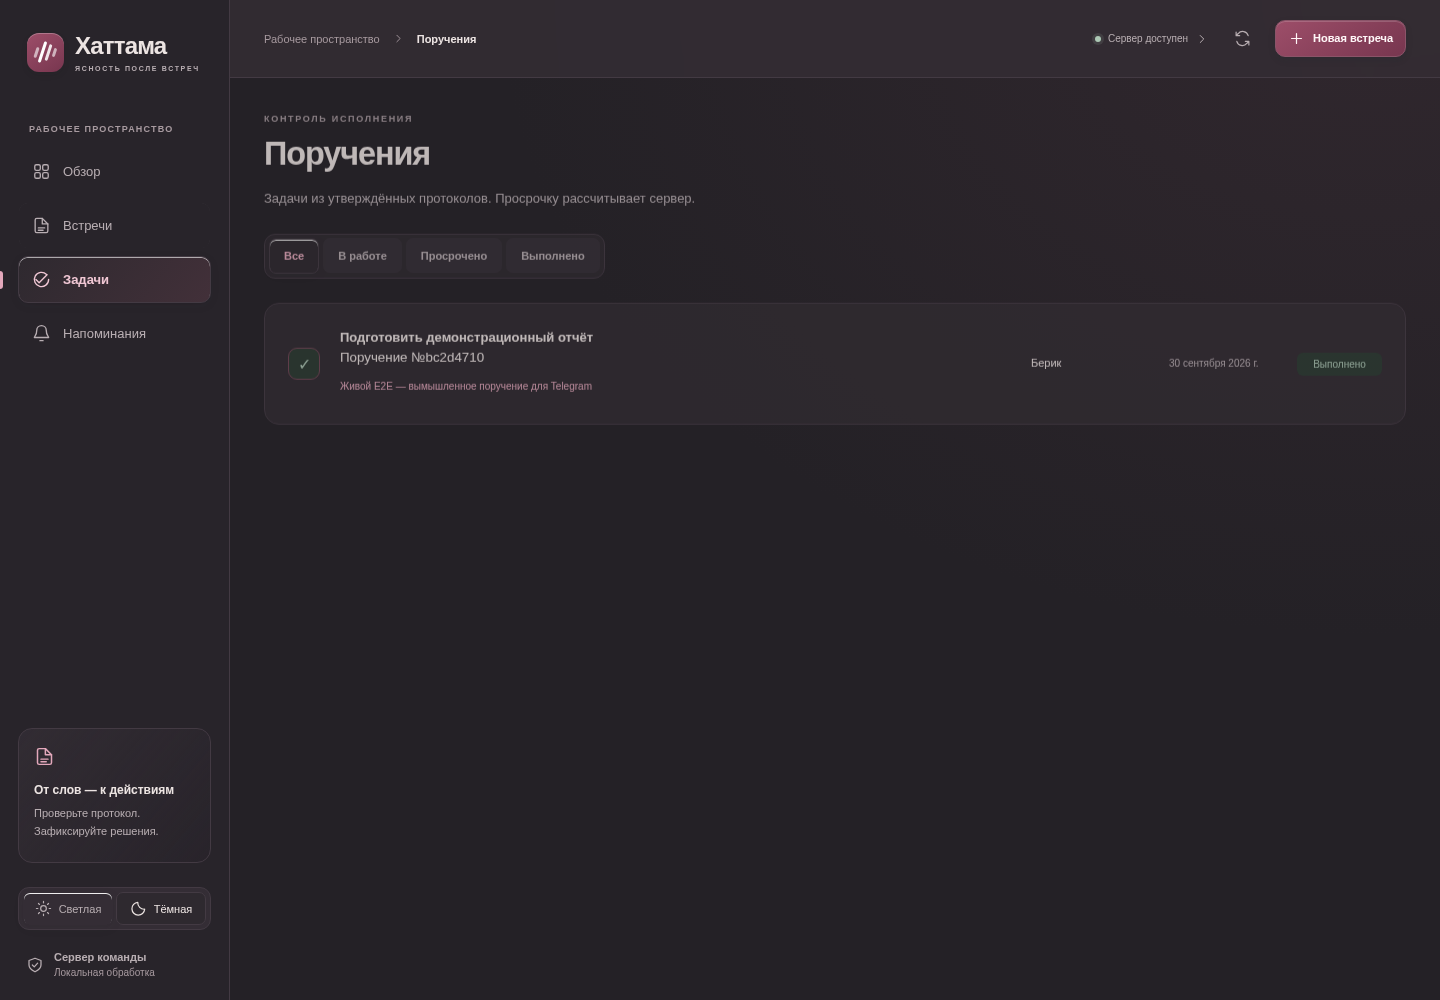 Исполнитель, срок и статус. Здесь показано вымышленное проверочное поручение, завершённое через живой Telegram-бот. |
Проверка с телефона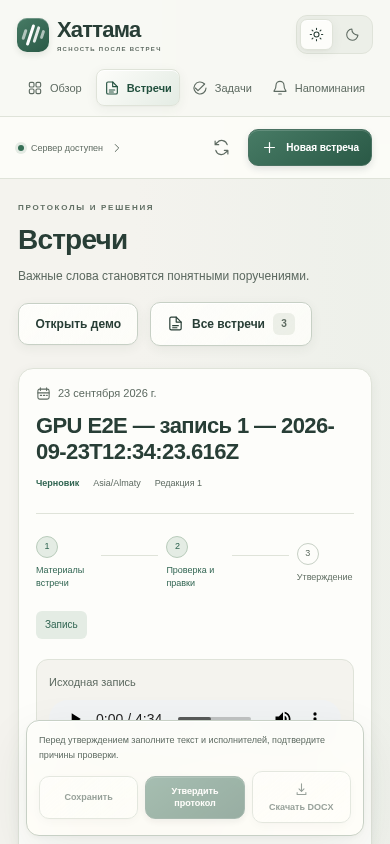 Адаптивный экран и закреплённая панель действий. |
Это настоящие снимки развёрнутого приложения из серверной приёмки, без имитации интерфейса. Аудио на desktop/mobile получено в историческом прогоне Whisper large-v3 + Community-1 + Qwen3:8b; эти изображения не выдаются за результат финального профиля 32B. Настоящие аудиопротоколы на снимках остаются черновиками.
Живой Telegram
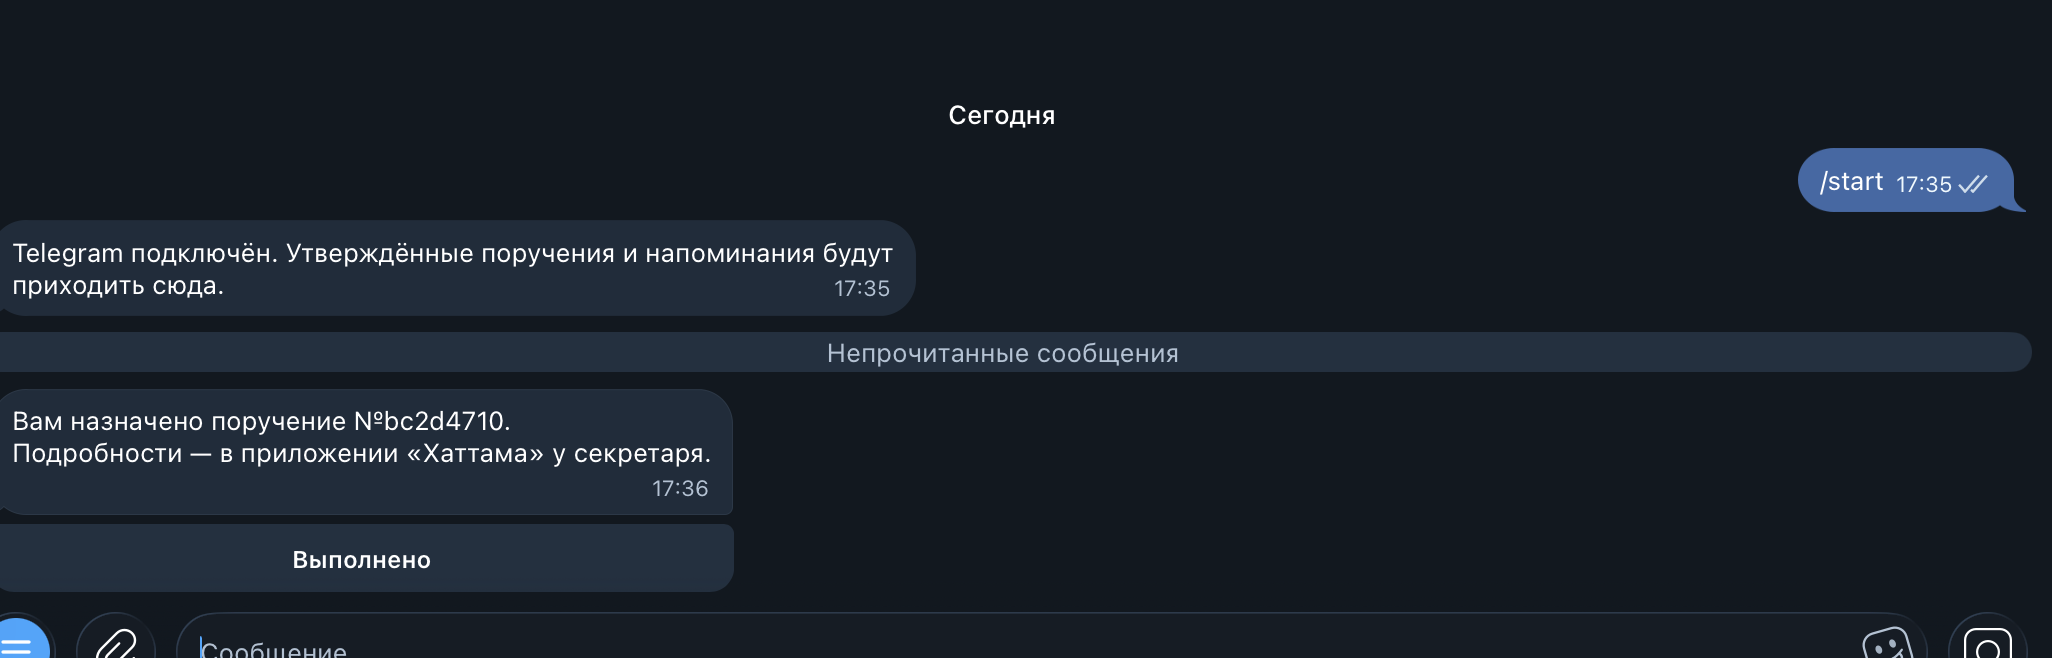
Скриншот предоставлен пользователем и сохранён без изменений. Бот подтверждает подключение и доставляет нейтральное уведомление с кнопкой «Выполнено»; детали поручения остаются в приложении. Возврат статуса в реестр и сохранность после перезапуска подтверждены в серверном отчёте.
Сравнить документы по одной записи
| Документ | Назначение | Открыть |
|---|---|---|
| Пример из задания · запись №1 | Предоставленный организаторами протокол для сравнения; не пословная разметка аудио | PDF примера |
| Фактический ML-черновик · запись №1 | Результат моделей на том же входе; требует проверки, не является утверждённым протоколом | PDF результата модели |
Эти PDF — материалы для просмотра и сравнения. Встроенный пользовательский экспорт приложения остаётся DOCX; наличие файлов в репозитории не означает появления PDF-endpoint или автоматического утверждения результата.
В исходном примере есть расхождения с записью, поэтому он не использован как подсказка модели или эталон для расчёта WER. В PDF результата сохранены реальные ошибки и предупреждения — это демонстрация полученного черновика.
Реальный результат: аудио в проект протокола
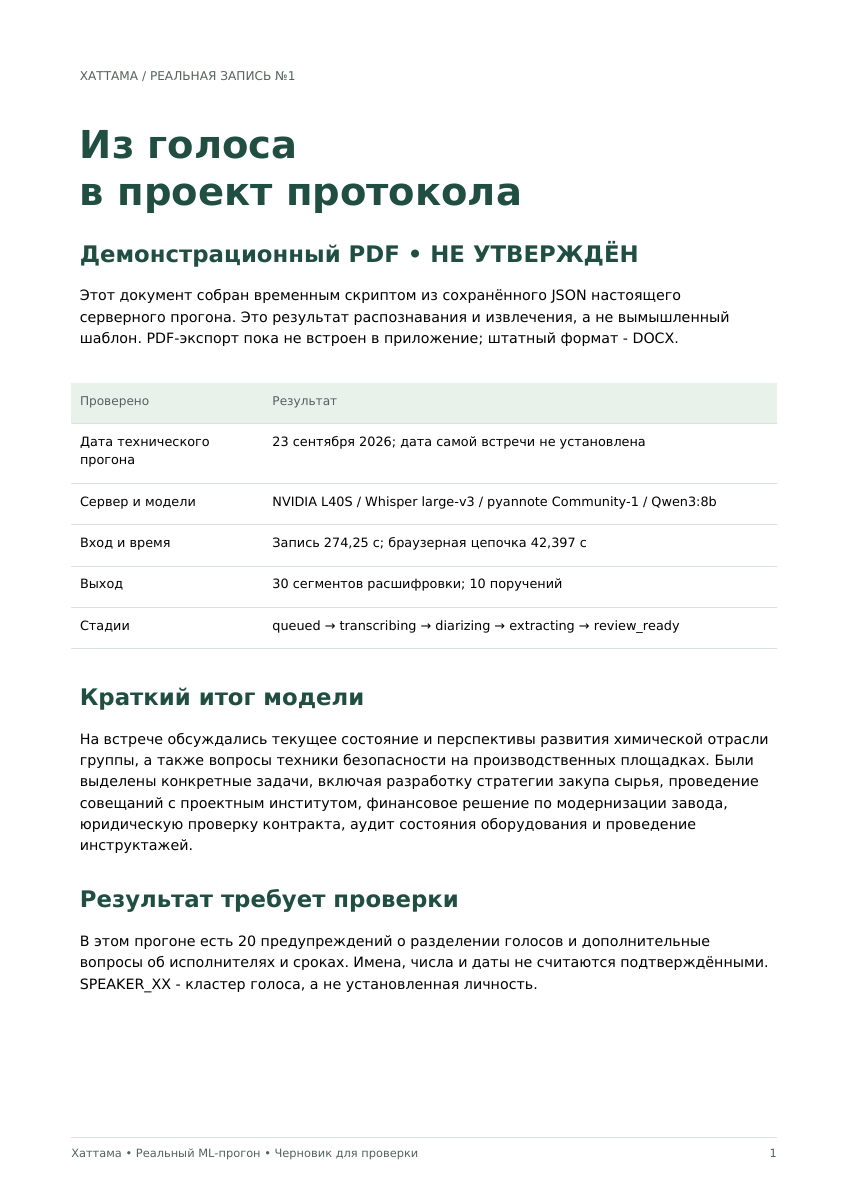
Да, у нас есть сохранённые результаты настоящих серверных запусков. Ниже показан браузерный прогон записи №1 на Brev / NVIDIA L40S от 23 сентября 2026 года: загрузка через React → FastAPI → Whisper large-v3 → pyannote Community-1 → Ollama Qwen3:8b → сохранённый проект протокола.
Открыть демонстрационный PDF — 4 страницы · Посмотреть исходный JSON-фрагмент · Отчёт о серверной приёмке
PDF собран временным скриптом из реального сохранённого JSON, без нового запуска GPU. Это демонстрация результата обработки, не встроенная функция PDF-экспорта и не утверждённый протокол. Штатный экспорт приложения — DOCX. Предупреждения, неизвестные исполнители и отсутствующие даты сохранены. Пример относится к прогону 8B, а результаты последующих улучшений 32B приведены отдельно ниже; версии не смешиваются.
Что сделано и проверено целиком
| Компонент | Реализовано | Подтверждение |
|---|---|---|
| Frontend | Загрузка аудио/текста, стадии, редактор, источники, темы, мобильная версия | Две реальные записи загружены через браузер; результат появился без перезагрузки |
| Backend | API, очередь, SQLite, версии, сохранение аудио, HTTP Range, восстановление | Реальный проход до review_ready, данные сохранены после перезапуска |
| ML | Распознавание, кластеры голосов, summary, поручения и проверка оснований | Настоящие Whisper + pyannote + Qwen на L40S; исходные результаты сохранены |
| Протокол | Проверка, утверждение, снимок документа, DOCX | На известном вымышленном тексте: настоящий Qwen → проверка в UI → утверждение → скачанный DOCX |
| Telegram | Привязка по одноразовой ссылке и числовому ID, доставка, кнопка «Выполнено» | Пользователь получил живое уведомление и нажал кнопку; в приложении появился done, revision=3 |
| Развёртывание | Собранный UI раздаётся FastAPI; модели и данные на сервере | systemd hatama.service, доступ через SSH-туннель; после перезапуска привязка и статус сохранены, DOCX не изменился |
| Автоматические проверки | Backend/SQLite/контракты и браузерные сценарии с подменами моделей | 88 backend-тестов + 5 subtests; 35 Playwright-сценариев. Отдельно от настоящего ML |
В живом Telegram-тесте отправлено одно нейтральное уведомление, без текста встречи. Проверка с реальным ботом использовала вымышленное поручение; протоколы настоящих аудиозаписей не утверждались автоматически.
Конкретный результат браузерного прогона
| Запись | Длительность аудио | Время цепочки с действиями браузера | Сегменты | Поручения |
|---|---|---|---|---|
| №1 | 274,25 с | 42,397 с | 30 | 10 |
| №2 | 206,03 с | 33,590 с | 32 | 8 |
Обе встречи прошли queued → transcribing → diarizing → extracting → review_ready. JavaScript-ошибок в этом прогоне не было. Это измерения конкретной серверной приёмки Qwen3:8b, а не обещание скорости для любой записи. Дата исходных встреч не установлена; дата теста не используется как подтверждённая дата встречи.
Как распарсили голос
Дословный фрагмент сохранённого результата №1; ошибки распознавания и границы реплик здесь не исправлялись:
| Время | Кластер голоса | Распознанный текст |
|---|---|---|
| 00:00.00–00:14.90 | SPEAKER_02 | Коллеги, начинаем. На повестке один вопрос – состояние и перспективы развития химической отрасли в рамках группы. Прошу коротко и по существу у нас 5 минут. Гульмира Сериковна, вам слово по текущей ситуации. |
| 00:14.90–00:34.88 | SPEAKER_00 | Спасибо. По итогам 9 месяцев загрузка мощностей на химических активах группы держится на уровне 71%. Основная проблема – устаревшее оборудование на двух площадках и отсутствие единой стратегии закупа сырья. Мы |
| 00:34.88–00:39.60 | SPEAKER_00 | теряем на логистике до 8% от себестоимости продукции. |
| 00:39.82–00:43.80 | SPEAKER_02 | Понятно. Тимур Булатович, что у вас по инвестпроектам? |
SPEAKER_02 снова появляется после SPEAKER_00: модель выделяет голосовые кластеры, а не просто нумерует реплики. Имя человека этим не доказано — связь голоса с участником проверяется отдельно.
Из реплики 01:16.48–01:36.34 извлечено поручение:
{
  "title": "Разработать единую стратегию закупа сырья для химических активов группы",
  "assignee": "Гульмира Сериковна",
  "due_text": "срок до 15 октября",
  "due_date": null,
  "review_reasons": ["deadline_needs_review"]
}
Это сокращённое представление фактического ответа: полный ID задачи и ссылка на исходную реплику есть в JSON-примере. Календарная дата осталась null: год не подтверждён. Во всём прогоне №1 есть 20 предупреждений о голосах и дополнительные вопросы об исполнителях/сроках; качество требует сверки с записью.
Как результат выглядит в приложении
PDF содержит итог, пять фрагментов расшифровки с голосами и временем, все десять извлечённых поручений, ссылки на времена источников и замечания к проверке. Meeting ID, версия прогона и SHA-256 исходного JSON указаны внутри документа. Полные служебные JSON и скриншоты остаются в локальном artifacts/server-e2e/; в репозиторий добавлены только выбранные демонстрационные материалы.
Результаты ML
Проверено 23 сентября 2026 года на арендованном Linux-сервере Brev с NVIDIA L40S, класс 48 GB VRAM. Настоящие модели запускались на сервере; Mac использовался для разработки, Git, подключения и просмотра результатов.
| Проверка | Результат | Что именно подтверждено |
|---|---|---|
| Qwen3:32b, RU/KZ/смешанный синтетический текст, набор v2 | 8 / 8 · 100% сценариев | По ручной сверке проверенных полей: состав поручений, исполнитель, срок и основания |
| Qwen3:8b, тот же набор v2 | 4 / 8 · 50% сценариев | Базовый вариант для сравнения; поэтому рекомендована 32B |
| Покрытие обязательного минимума ТЗ | ≈71% | 3 пункта подтверждены, 4 частичны; частичный пункт имеет вес 0,5. Методика |
| Модульные ML-регрессии на сервере | 48 / 48 | Источники, даты, исполнители, отрицания, привязка голосов и восстановление речи |
| Проверка объединённой версии | 120 backend + 31 subtest | После объединения ML, frontend и Telegram: все backend-тесты и сборка frontend прошли на сервере; 48 ML-тестов входят в этот набор |
| Отдельная серверная приёмка приложения | 88 backend + 35 E2E | Проверки коллеги на указанной в отчёте версии; также подтверждён живой Telegram на вымышленном примере |
| Две предоставленные аудиозаписи | 2 / 2 полных прохода | Настоящие Whisper → pyannote → Ollama завершили обработку |
| Реальное аудио через HTTP API | review_ready | Исходный прогон №1 и финальный прогон №2: загрузка, очередь, стадии ML и сохранение результата |
| Казахское аудио: 3 фразы FLEURS, 43,14 с | WER 32,08% | 17 словных правок на 53 слова. Малый тест чтения живыми дикторами; не оценка качества совещаний |
| WER / DER на предоставленных встречах | Не измерены | Нет независимой проверенной пословной и голосовой разметки |
100% относится только к восьми проверенным синтетическим текстовым сценариям. Это не оценка точности на произвольных встречах и не результат проверки казахского аудио. Эталоны сценариев используются при оценке, а не передаются модели. Набор небольшой и использовался при разработке; независимую оценку на новых встречах ещё предстоит провести.
Финальные полные аудиопрогоны с Qwen3:32b и восстановлением речевых пропусков:
| Запись | Длина записи | Весь ML-проход | ASR | Диаризация |
|---|---|---|---|---|
| №1 | 274,25 с | 56,04 с | 16,19 с | 5,90 с |
| №2 | 206,03 с | 47,54 с | 14,63 с | 5,22 с |
Во второй записи повторный ASR занял ещё 3,79 с и восстановил пропущенное поручение о смете. В финальных протоколах остаются ошибочный исполнитель, пропущенное обязательство и потерянные сроки: автоматический результат требует проверки. Завершение обработки не заменяет прослушивание и сверку. Итоговый отчёт ML содержит исходный baseline и результаты улучшений; ML_SETUP.md — настройки и версии; ML_MODEL_RESEARCH.md — исследованные альтернативы.
Как устроен ML
flowchart LR
    A["Аудиозапись"] --> F["FFmpeg<br/>mono · 16 kHz"]
    F --> W["Whisper large-v3<br/>текст и времена слов"]
    F --> P["pyannote Community-1<br/>интервалы голосов"]
    W --> J["Сопоставление<br/>слов и говорящих"]
    P --> J
    T["Готовая расшифровка"] --> L["Qwen3:32b<br/>итог и поручения"]
    J --> L
    L --> V["Проверка JSON,<br/>источников и дат"]
    V --> H["Проверка человеком"]
    H --> D["Утверждение<br/>DOCX · реестр"]
    classDef input fill:#eaf3f5,stroke:#497582,color:#153847;
    classDef model fill:#142f42,stroke:#5ad6c6,color:#ffffff;
    classDef review fill:#e9f6ee,stroke:#499d76,color:#173c2a;
    class A,T input;
    class F,W,P,J,L model;
    class V,H,D review;
| Этап | Реализация | Почему это важно |
|---|---|---|
| Подготовка записи | FFmpeg → PCM WAV, mono, 16 kHz | Одинаковый вход для распознавания и диаризации |
| Распознавание | faster-whisper, Whisper large-v3, CUDA, int8_float16, VAD, времена слов | Текст и его положение в записи; смешанная речь требует отдельной оценки |
| Разделение голосов | pyannote Community-1, exclusive diarization | Кластеры голосов и границы реплик; кластер сам по себе не является именем |
| Извлечение | Ollama + Qwen3:32b, без thinking, JSON Schema | Итог, поручения, предполагаемые исполнители и дословные формулировки сроков |
| Валидация | Python, проверка ссылок на реплики, детерминированный разбор дат | Несуществующий источник отклоняется; отсутствующие сведения требуют проверки |
| Утверждение | Редактор → revision → отдельный снимок | Экспортируется сохранённая утверждённая версия |
Что улучшено
- Более сильная локальная LLM. Qwen3:32b выбрана после сравнения с 8B на одном наборе текстовых сценариев.
- Короткие ссылки для модели. Внутри запроса используются
S1,S2и далее; перед проверкой они возвращаются к исходным ID. Неизвестные ссылки не подменяются подходящими. - Календарную дату вычисляет код. Модель возвращает дословный
due_text, а полеdue_dateв её ответе —null. Приложение распознаёт полную дату из подтверждённой цитаты. Год не дополняется из даты запуска. - Проверка исполнителя стала строже. Голосовой
SPEAKER_00не принимается за имя. Поддержаны дополнительные русские и казахские обязательства от первого лица; добавлены проверки вопросов и явных отрицаний. - Сохранены предупреждения при сопоставлении речи. Слова нулевой длительности и неуверенная привязка к голосу остаются видимыми для проверки, в том числе после объединения слов в реплику.
- Результаты можно воспроизвести. Отчёты содержат конфигурацию, сведения о моделях, хеш входа и ML-адаптера, ревизию Git при её доступности и длительности этапов.
Это улучшения извлечения и проверки результата. Они не означают, что модель безошибочно понимает любую формулировку отрицания или всегда правильно узнаёт говорящего. Дополнительное восстановление пропусков ASR включается отдельно через ASR_GAP_RECOVERY; по умолчанию оно выключено, восстановленный текст помечается для проверки. Его результаты — в отчёте ML.
Почему сейчас без дообучения
У команды две предоставленные встречи. Обучение на них с последующей оценкой на тех же записях не показало бы качество на новых совещаниях. На этом этапе мы сравнили готовые модели и улучшили обработку источников, сроков и неопределённости. Следующий шаг — отдельный размеченный набор RU, KZ и смешанных записей с новыми говорящими; затем измерение WER/DER и решение о дообучении. Исследование моделей и ограничений.
Быстрый запуск
1. Открыть готовое demo без моделей
Нужны Python 3.12 и Node.js ≥22. Demo использует заранее подготовленные вымышленные данные: оно показывает возможности продукта без GPU и скачивания весов.
Из корня репозитория, первый терминал:
python3.12 -m venv .venv
.venv/bin/python -m pip install -r backend/requirements.txt
.venv/bin/uvicorn backend.app.main:app --host 127.0.0.1 --port 8000
Во втором терминале:
cd frontend
npm ci
npm run build
npm run dev
Откройте http://127.0.0.1:5173 и нажмите «Открыть демо». Интерфейс явно помечает вымышленные данные. Каждый запуск создаёт отдельную встречу.
После сборки FastAPI также раздаёт frontend/dist: http://127.0.0.1:8000 работает без Vite. npm run preview предназначен для просмотра статики и не настраивает API proxy.
Данные по умолчанию сохраняются в data/; для отдельного стенда задайте DATA_DIR. Корневой .env загружается автоматически, переменные окружения имеют приоритет. Рабочие записи не нужно удалять для повторного показа.
2. Настроить настоящее ML на сервере
Все команды моделей, ML-прогонов и ML-тестов выполняются на арендованном сервере. С компьютера разработчика только подключитесь:
brev shell hatama-ml-gpu
В SSH-сессии перейдите в корень серверного checkout. Подготовьте окружение, CUDA и веса по ML_SETUP.md, затем используйте профиль:
# Только на Linux GPU-сервере, из корня проекта.
nvidia-smi
export ASR_MODEL="$PWD/models/gpu/asr"
export DIARIZATION_MODEL_PATH="$PWD/models/gpu/diarization"
export ASR_DEVICE=cuda
export ASR_COMPUTE_TYPE=int8_float16
export ASR_GAP_RECOVERY=true
export OLLAMA_BASE_URL=http://127.0.0.1:11434
export OLLAMA_MODEL=qwen3:32b
export OLLAMA_THINKING=false

ollama pull qwen3:32b
eval/.venv/bin/python scripts/check_models.py --strict
eval/.venv/bin/uvicorn backend.app.main:app --host 127.0.0.1 --port 8000
Ollama должна быть запущена на том же сервере. Веса подготавливаются отдельно; inference не скачивает их при отсутствии. Для Community-1 требуется принятие условий доступа владельцем аккаунта. /api/health показывает готовность провайдеров, а не точность моделей.
UI подключается к серверному backend через SSH-туннель; подробности — в инструкции backend. У MVP нет авторизации пользователей, поэтому обычный запуск слушает loopback. Публичное размещение требует отдельной настройки доступа.
Как проверить решение
Настоящие модели — на Brev
После brev shell hatama-ml-gpu, из корня подготовленного серверного checkout:
# Извлечение на фиксированном синтетическом наборе RU/KZ/RU-KZ.
eval/.venv/bin/python scripts/evaluate_extraction.py \
  --cases eval/text_quality_cases.json \
  --model qwen3:32b \
  --output eval/results/reproduce-qwen3-32b.json

# Настоящая запись: ASR + диаризация + LLM, с диагностикой.
eval/.venv/bin/python scripts/run_ml_checkpoint.py eval/audio/meeting-1.mp3 \
  --occurred-at 2026-09-23 --seconds 3600 --min-speakers 2 \
  --full --diagnostics --output eval/results/reproduce-meeting-1.json

# Регрессии адаптера; также выполняются на сервере.
PYTHONPATH=backend eval/.venv/bin/python -m unittest \
  backend.tests.test_ml \
  backend.tests.test_ml_extraction_quality \
  backend.tests.test_ml_alignment \
  backend.tests.test_ml_diagnostics \
  backend.tests.test_ml_gap_recovery -v
Исходный аудиофайл не включён в Git. Для собственной записи замените путь и укажите её настоящую дату. При повторе выберите новое имя JSON: отчёты предыдущих запусков сохраняются. Успешный exit code означает завершение обработки; правильность полей проверяется по источникам. Политика оценки — eval/README.md.
Frontend и backend — отдельная проверка
Эту часть команда проверяла отдельно. Серверная приёмка подтверждает браузерную загрузку двух настоящих записей, DOCX и живой Telegram на вымышленном примере, выполнение задачи и сохранность после перезапуска. На версии из отчёта прошли 88 backend-тестов и 35 E2E. Дополнительные сведения — QA интерфейса и ML-stub стенд. Эти счётчики не являются метриками качества ML и не складываются с нашими регрессиями.
ML-stub стенд сохранён. Заглушка заменяет только модели: FastAPI, загрузка, очередь, SQLite, версии, утверждение, DOCX и React остаются настоящими. После установки backend/requirements-dev.txt в .venv:
cd frontend
npm ci
npm run test:integration
Команда собирает UI и запускает изолированный тестовый backend. Заглушки явно помечены в UI/DOCX и не включаются в обычном запуске приложения. Это проверка интеграции, не качества ML. Настройка Python, браузера, Windows и пути отчётов — в полной инструкции.
Для уже запущенного backend и frontend отдельно используется npm run test:e2e; настройка браузера и production-сборки описана в QA.
Демонстрация за три минуты
| Время | Что показать | Что увидит жюри |
|---|---|---|
| 0:00–0:30 | Открыть demo или заранее обработанную настоящую встречу | Проект протокола, источники и явное обозначение режима |
| 0:30–1:10 | Нажать «Источник» у поручения | Подтверждающая реплика; для аудио — переход к моменту записи |
| 1:10–1:50 | Уточнить исполнителя и срок, подтвердить проверку, сохранить | Человек контролирует спорные поля; дата без основания не выдумывается |
| 1:50–2:20 | Утвердить протокол и скачать DOCX | Документ из утверждённой версии, с основаниями и расшифровкой |
| 2:20–3:00 | Открыть реестр, завершить задачу, показать ML-результаты | Путь от встречи до исполнения и прозрачные границы измерений |
Вымышленное demo содержит три задачи: план интеграции, тестовые записи и бюджет сервера. У бюджета событийный срок — после обсуждения с организаторами, без придуманной календарной даты. Данные: fixtures/demo.json. Отдельный пример смешанного текста требует настоящей LLM при импорте. Расширенный сценарий защиты — docs/demo.md.
Технологии и структура
| Часть | Технологии | Основные файлы |
|---|---|---|
| Интерфейс | React 18, TypeScript 5.6, Vite 6 | frontend/ |
| API и очередь | Python, FastAPI, один последовательный обработчик | backend/app/main.py |
| Хранение и версии | SQLite, файлы записей, optimistic locking через revision | backend/app/storage.py |
| ML | faster-whisper, CTranslate2, pyannote.audio, PyTorch, Ollama | backend/app/ml.py |
| Документ | python-docx, снимок утверждённой версии | backend/app/export.py |
| Проверки | unittest, pytest, Playwright; реальные GPU-прогоны отдельно | backend/tests/, frontend/tests/, eval/ |
Точные frontend-версии фиксирует lock-файл. GPU-профиль с PyTorch 2.8.0+cu126, torchaudio 2.8.0 и совместимым TorchCodec 0.7.0 описан в ML_SETUP.md. Публичная HTTP-схема при ML-улучшениях не менялась.
Границы текущего MVP
| Уже работает | Требует дальнейшей работы |
|---|---|
| Импорт аудио и текста, фоновые стадии, проверка источников | Численная оценка WER/DER на независимой RU/KZ выборке |
| Сопоставление голосов человеком, правки, конфликты версий | Надёжное автоматическое установление личности по голосу |
| Утверждение, DOCX, реестр, локальные напоминания и отдельный Telegram-канал | Встроенный экспорт PDF, почта и интеграция с СЭД |
| Серверный inference без автоматического облачного fallback | Бот Zoom/Meet/Teams и потоковый захват встреч |
Аудио ограничено 100 МБ и одним часом, текст — 80 000 символов. Относительные и событийные сроки требуют проверки. Черновик до сохранения живёт в памяти вкладки. Работа с неизвестным говорящим и низкой уверенностью остаётся частью проверки человеком.
Документы для проверки проекта: отчёт ML · настройка ML · исследование моделей · соответствие ТЗ · HTTP-контракт · QA · ML-stub стенд.
Авторы коммитов
История коммитов
- 2026-09-23 17:28Merge frontend redesign with Telegram integrationlazyyy66
- 2026-09-23 17:25romalazyyy66
- 2026-09-23 16:59cimmutlazyyy66
- 2026-09-23 17:54Merge remote-tracking branch 'origin/codex/ml-gpu-validation' into codex/ml-qualityfffoke
- 2026-09-23 17:54Add direct PDF links and one-minute demo guidefffoke
- 2026-09-23 17:51Publish reference and actual ML draft PDFs for comparisonfffoke
- 2026-09-23 17:50Document real server results with audio example and PDF draftfffoke
- 2026-09-23 17:49Show real interface and Telegram evidence in project READMEfffoke
Все коммиты (25)
- 2026-09-23 17:45Merge completed frontend and Telegram validation with ML improvementsfffoke
- 2026-09-23 17:41Validate deployed GPU pipeline and live Telegram completionfffoke
- 2026-09-23 17:41Improve ML evidence and speech recovery with measured GPU resultsfffoke
- 2026-09-23 17:30Merge latest main for full-stack GPU validationfffoke
- 2026-09-23 17:17Merge remote-tracking branch 'origin/main' into codex/ml-qualityfffoke
- 2026-09-23 17:17Redesign corporate frontend with dual themes and verified review workflowlahmut-group
- 2026-09-23 15:46Merge pull request #1 from BAITC-Hacks/codex/backend-integrationlazyyy
- 2026-09-23 16:46Document Brev GPU ML validationfffoke
- 2026-09-23 15:38romalazyyy66
- 2026-09-23 16:01Merge remote-tracking branch 'origin/codex/frontend-demo'fffoke
- 2026-09-23 16:01Merge remote-tracking branch 'origin/main'fffoke
- 2026-09-23 16:01Complete local ML speech pipelinefffoke
- 2026-09-23 15:51Align frontend documentation with integrated backendlahmut-group
- 2026-09-23 15:49Merge remote-tracking branch 'origin/main' into codex/frontend-demolahmut-group
- 2026-09-23 15:39isma frontlahmut-group
- 2026-09-23 15:20add some filesfffoke
- 2026-09-23 14:43first commitfffoke
Структура репозитория (107 файлов)
.env.example
.gitignore
README.md
backend/INTEGRATION_HANDOFF.md
backend/__main__.py
backend/app/__init__.py
backend/app/export.py
backend/app/main.py
backend/app/ml.py
backend/app/storage.py
backend/app/telegram.py
backend/app/telegram_store.py
backend/requirements-dev.txt
backend/requirements-ml.txt
backend/requirements-tested.txt
backend/requirements.txt
backend/smoke.py
backend/testing/__init__.py
backend/testing/ml_stub.py
backend/testing/server.py
backend/testing/telegram_stub.py
backend/tests/conftest.py
backend/tests/test_backend.py
backend/tests/test_ml.py
backend/tests/test_ml_alignment.py
backend/tests/test_ml_diagnostics.py
backend/tests/test_ml_extraction_quality.py
backend/tests/test_ml_gap_recovery.py
backend/tests/test_smoke.py
backend/tests/test_stub.py
backend/tests/test_telegram.py
contracts/README.md
contracts/TELEGRAM.md
deploy/hatama.service
docs/DEMO_QUICK.md
docs/ML_MODEL_RESEARCH.md
docs/ML_QUALITY_REPORT.md
docs/ML_SETUP.md
docs/MVP_PLAN.md
docs/QA.md
docs/REQUIREMENTS_STATUS.md
docs/SERVER_E2E_REPORT.md
docs/TELEGRAM.md
docs/TESTING_WITH_ML_STUBS.md
docs/artifacts/README.md
docs/artifacts/model-meeting-1.pdf
docs/artifacts/pdf-provenance.json
docs/artifacts/pdf-qa.json
docs/artifacts/reference-meeting-1.pdf
docs/assets/frontend-review-desktop.png
docs/assets/frontend-review-mobile.png
docs/assets/frontend-tasks-dark.png
docs/assets/hatama-hero.svg
docs/assets/real-audio-pdf-preview.png
docs/assets/real-audio-server-ui.png
docs/assets/telegram-live.png
docs/demo.md
docs/examples/real-audio-excerpt.json
docs/tasks/01_ML_GPU.md
docs/tasks/01_ML_HANDOFF.md
docs/tasks/02_BACKEND_INTEGRATION.md
docs/tasks/03_FRONTEND_DEMO.md
eval/.gitignore
eval/README.md
eval/benchmarks/2026-09-23.json
eval/text_quality_cases.json
fixtures/demo.json
fixtures/mixed_meeting.txt
frontend/.gitignore
frontend/README.md
frontend/index.html
frontend/integration/fixtures.ts
frontend/integration/full-stack.spec.ts
frontend/integration/telegram.spec.ts
frontend/package-lock.json
frontend/package.json
frontend/playwright.config.ts
frontend/playwright.integration.config.ts
frontend/server-review-validation.mjs
frontend/server-validation.mjs
frontend/src/App.tsx
frontend/src/CreateMeeting.tsx
frontend/src/HealthStatus.tsx
frontend/src/Icon.tsx
frontend/src/Overview.tsx
frontend/src/SourceTag.tsx
frontend/src/TelegramPanel.tsx
frontend/src/ThemeToggle.tsx
frontend/src/api.ts
frontend/src/main.tsx
frontend/src/style.css
frontend/src/types.ts
frontend/tests/design.spec.ts
frontend/tests/review.spec.ts
frontend/tests/source-label.spec.ts
frontend/tsconfig.json
frontend/vite.config.ts
output/pdf/hatama-real-audio-draft.pdf
pytest.ini
scripts/check_models.py
scripts/compare_asr_vad.py
scripts/evaluate_extraction.py
scripts/evaluate_kazakh_asr.py
scripts/evaluate_refinement.py
scripts/prepare_models.py
scripts/run_ml_checkpoint.py
start-backend.cmd
Обсуждение 0 комментариев
Войдите, чтобы комментироватьПока нет комментариев — будьте первым.