О проекте
Команда: MNIST
Кейс HackAlem.ai: Инновации — Самрук-Казына
Стадия: Рабочий MVP
Задача кейса: «Хаттама»: протокол и поручения по аудиозаписи совещания (каз./рус./смешанная речь)
Суть
Локальное приложение, которое по аудиозаписи совещания готовит протокол: стенограмма с диаризацией, краткое содержание и поручения со ссылками на реплики. Человек проверяет результат, затем он экспортируется в DOCX или PDF.
Как устроено
ffmpeg приводит запись к моно WAV 16 кГц. pyannote Community-1 размечает интервалы голосов, Whisper large-v3-turbo (Transformers) распознаёт речь окнами до 25 секунд, текст сопоставляется с говорящими. Qwen3-8B через Ollama возвращает JSON с кратким содержанием и поручениями. Код проверяет, что ссылки ведут на реальные реплики, что ответственный и срок есть в цитате, и консервативно нормализует даты. UI на React с вкладками для правки и подтверждения, хранение в SQLite, экспорт через python-docx и LibreOffice. Есть альтернативный вариант на CTranslate2, pyannote 3.1 и Qwen3.5-4B через llama.cpp.
Ключевые решения
- Whisper large-v3-turbo
- pyannote speaker-diarization-community-1
- structured JSON extraction
- source reference validation
- date normalization
- human-in-the-loop review
Особенности
Всё работает на локальных моделях, с фиксированными ревизиями и digest. Модели речи загружаются по очереди, после каждой очищается память GPU. Если реплику или участника правят, подтверждение поручения снимается. README прямо говорит, что WER/CER не заявлены.
Стек
Python · FastAPI · React · TypeScript · Vite · SQLite · PyTorch · Transformers · Ollama · python-docx · LibreOffice
Модели
Whisper large-v3-turbo · pyannote Community-1 · Qwen3-8B (Ollama) · Qwen3.5-4B (llama.cpp)
Проект создан за 5 часов на финале хакатона HackAlem.ai (23 сентября 2026, Астана). Код — BAITC-Hacks/hack-2b778d9f-mnist.
README
README.mdJinalys AI
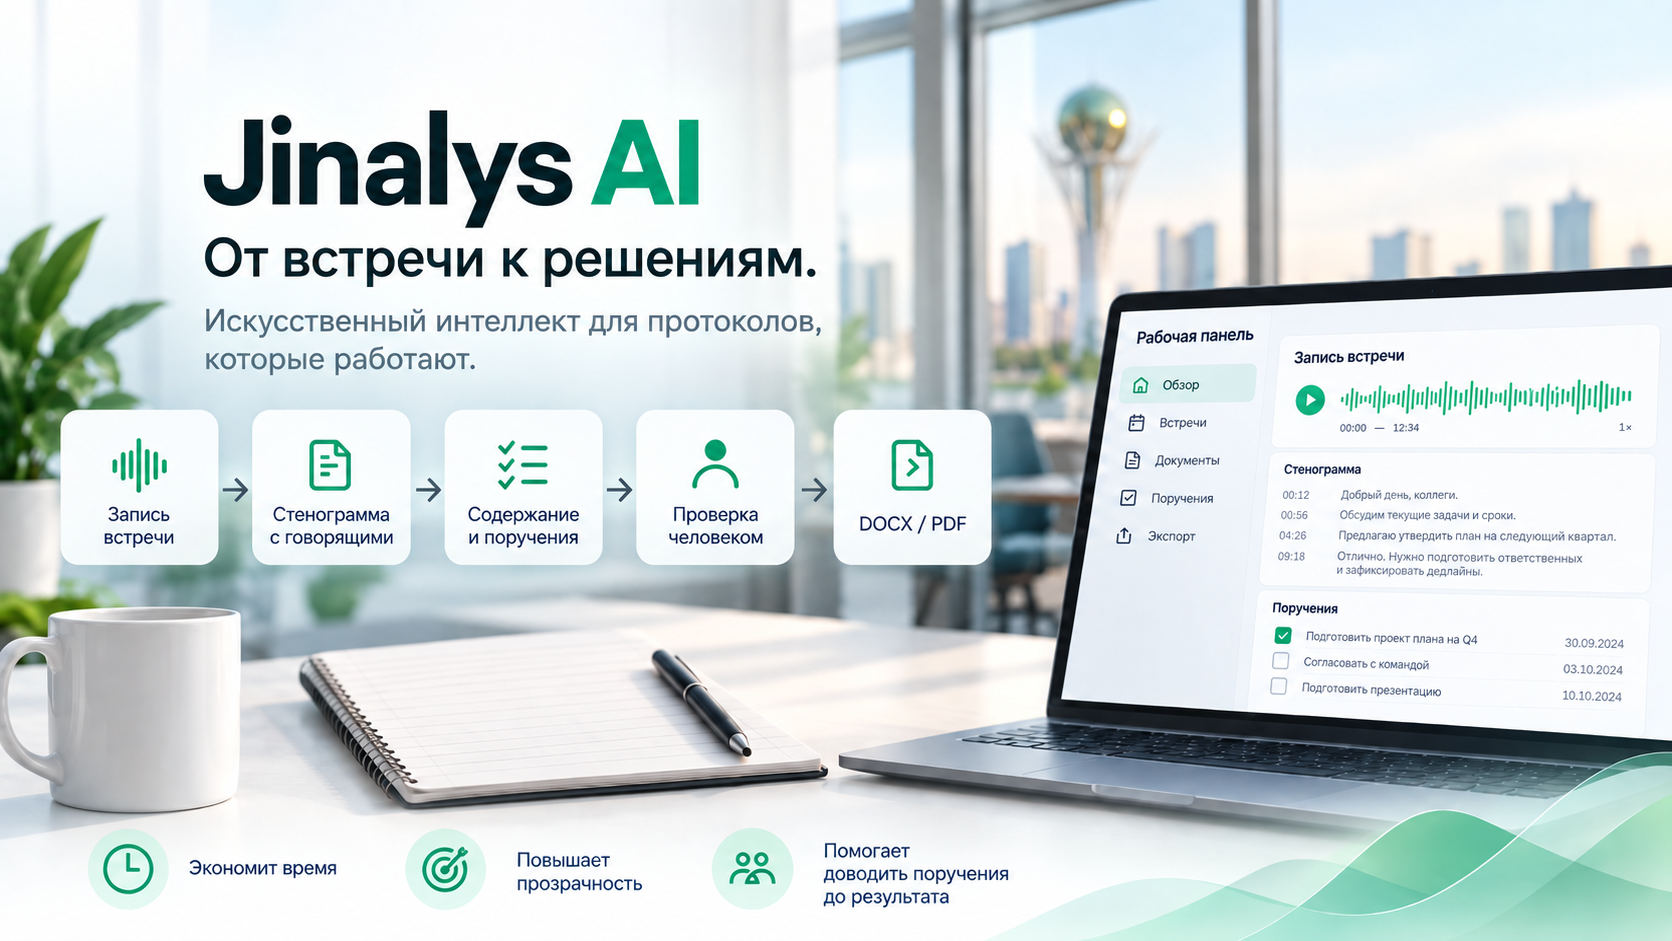
От встречи к решениям.
2. Краткое описание
Запись встречи → стенограмма с говорящими → содержание и поручения → проверка человеком → DOCX / PDF.
Jinalys AI помогает секретарям и организаторам совещаний подготовить протокол по аудиозаписи. Вместо повторного прослушивания всей встречи пользователь получает редактируемый черновик и может проверить основания поручений по конкретным репликам.
Результат работы ИИ не считается утверждённым протоколом: имена, поручения и сроки проверяет человек. Основная версия использует локальные модели Transformers + Whisper Turbo, pyannote Community-1 и Ollama/Qwen3-8B.
3. Что реализовано
- Загрузка MP3 и WAV: до 200 MiB и 10 минут. Проверяются формат, длительность и целостность; звук подготавливается через ffmpeg.
- Распознавание речи и разделение голосов: реплики содержат текст, временной интервал и идентификатор говорящего. Неопределённые голоса и одновременная речь отмечаются отдельно.
- Краткое содержание и кандидаты в поручения: действие, ответственный, исходная фраза срока, дата исполнения, ссылки на реплики основания и подтверждения.
- Проверка источников: ссылки должны вести на существующие реплики. Ответственный и фраза срока проверяются на присутствие в цитируемом тексте. Неоднозначные даты остаются на уточнение.
- Редактирование человеком: исправление стенограммы, назначение проверенных имён голосам, изменение содержания, добавление и удаление кандидатов в поручения.
- Интерфейс с вкладками: «Обзор», «Стенограмма», «Участники», «Поручения», «Экспорт». Плеер и кнопка сохранения доступны при переключении разделов; можно прослушать отдельную реплику.
- Сохранение работы: SQLite хранит результаты и правки. Ссылку вида
?meeting=<id>можно использовать для повторного открытия встречи. Ошибочную обработку можно запустить повторно. - Экспорт: DOCX и, при наличии LibreOffice, PDF. Если PDF не сформирован, готовый DOCX остаётся доступным. Непроверенные кандидаты выделяются в документе.
Изменения исходных реплик, участников или содержания поручения снимают соответствующее подтверждение: сначала нужно сохранить правки, затем повторно проверить поручение.
Ограничения текущей версии
- Черновик требует проверки человеком. Наличие корректного JSON и ссылок на реплики не доказывает правильность содержания поручения.
- Языковое качество не гарантировано. Русская, казахская и смешанная речь входят в сценарии проекта, но полная оценка естественной многосторонней речи не завершена. Итоговые WER/CER и точность поручений в этом README не заявляются.
- Говорящие не идентифицируются по личности. Модель выделяет голосовые интервалы; имена назначаются вручную. Наложения речи, короткие фрагменты и границы реплик требуют проверки. Время соответствует окнам обработки, а не точному выравниванию каждого слова.
- Даты нормализуются консервативно. Например, календарная дата без года остаётся на уточнение; список участников не служит доказательством назначения ответственного.
- Ограниченный объём и параллелизм. До 10 минут и 200 MiB на запись, один процесс сервера и один обработчик. Минимальные требования к памяти и гарантированное время обработки не установлены.
- Локальная доверенная среда. Нет встроенной аутентификации, ролей пользователей и готовой защиты публичного сервиса. Для удалённого доступа используйте SSH-туннель.
- PDF зависит от LibreOffice и шрифтов. DOCX доступен отдельно.
- Нет live-подключения к Teams, Zoom или Meet, потоковой расшифровки, интеграции с СЭД, автоматической рассылки, напоминаний и дашборда исполнения поручений.
Состояние проверок и дальнейшая работа описаны в плане реализации. Выбор моделей и его ограничения — в исследовании моделей.
4. Как работает решение
- Пользователь загружает разрешённую запись, указывает дату встречи и, при необходимости, участников.
- Сервер подготавливает монофонический WAV, 16 кГц. Модель pyannote определяет интервалы голосов.
- Whisper распознаёт речь в коротких окнах до 25 секунд. Сервер сопоставляет текст с интервалами говорящих и отмечает неопределённость.
- Qwen получает стенограмму и формирует структурированный JSON: краткое содержание и кандидаты в поручения. Программа проверяет формат, ссылки на источники и однозначные сроки.
- Пользователь прослушивает спорные фрагменты, исправляет текст и имена, проверяет действие, ответственного, срок и подтверждение каждого поручения.
- После сохранения пользователь создаёт DOCX или DOCX и PDF для дальнейшего согласования.
5. Технологии
| Компонент | Технологии и назначение |
|---|---|
| Интерфейс | TypeScript, React, Vite; CSS для оформления и адаптивной компоновки |
| Сервер | Python, FastAPI, Uvicorn; Pydantic для проверки данных |
| Хранение | SQLite для встреч и правок; файловая система для аудио и документов |
| Подготовка аудио | ffmpeg, ffprobe, NumPy |
| Распознавание речи | openai/whisper-large-v3-turbo, Hugging Face Transformers, PyTorch |
| Разделение голосов | pyannote/speaker-diarization-community-1, pyannote.audio |
| Содержание и поручения | qwen3:8b, квантование Q4_K_M, локальный HTTP API Ollama |
| Документы | python-docx; LibreOffice для преобразования DOCX в PDF |
| Проверки | pytest, FastAPI TestClient/httpx; Vitest, Testing Library, jsdom |
| Подготовка моделей | Hugging Face Hub для предварительной загрузки весов |
Ревизии моделей и ожидаемый digest Qwen указаны в backend/models.json. Зависимости серверной логики и окружения GPU разделены на requirements.txt и requirements-gpu.txt. Зависимости интерфейса фиксирует frontend/package-lock.json.
6. Архитектура проекта
flowchart LR
    UI[Браузер: React] --> API[FastAPI]
    API --> Queue[Один обработчик заданий]
    Queue --> Audio[ffmpeg: подготовка WAV]
    Audio --> Diar[pyannote: интервалы голосов]
    Diar --> ASR[Whisper: распознавание речи]
    ASR --> LLM[Ollama / Qwen: содержание и поручения]
    LLM --> Check[Проверка структуры, источников и сроков]
    Check --> DB[(SQLite и локальные файлы)]
    DB --> API
    API --> UI
    UI --> Review[Правки и подтверждение человеком]
    Review --> API
    API --> Export[DOCX / PDF]
Модели речи вызываются последовательно; после использования освобождаются ссылки на модель и очищается кэш GPU. Встроенный обработчик запускает одно задание за раз. Приложение следует запускать одним процессом Uvicorn.
backend/
  app/
    main.py           API и очередь обработки
    audio.py          подготовка аудио, диаризация и распознавание
    process.py        сопоставление реплик и голосов
    extract.py        запрос к Qwen, проверка источников и сроков
    review.py         валидация пользовательских правок
    store.py          SQLite и файлы
    export.py         DOCX и PDF
    serve.py          точка запуска
  scripts/            проверка окружения и модельные прогоны
  tests/              автоматические тесты
  models.json         модели и ревизии
frontend/             интерфейс, сборка и тесты
evaluation/           сценарии и материалы оценки
docs/                 план реализации и исследование моделей
variants/llamacpp/     отдельный альтернативный вариант
Основной запуск описан ниже. В variants/llamacpp сохранён отдельный вариант на CTranslate2, pyannote 3.1 и Qwen3.5-4B/llama.cpp. Его зависимости и конфигурация не относятся к основному стеку этого README.
7. Установка и запуск
Команды рассчитаны на Bash в Linux или WSL и выполняются из корня проекта, если не указано другое.
7.1. Подготовьте окружение
Нужны:
- Python 3.11 и модуль
venv; - Node.js 22 и npm;
- ffmpeg и ffprobe в
PATH; - установленный Ollama;
- для PDF — LibreOffice и шрифт с кириллицей и казахскими символами, например DejaVu Sans.
В репозитории описано GPU-окружение Brev с NVIDIA L40S 48 GB и CUDA 12.6. Это конфигурация для проверки, а не доказанные минимальные требования. Код поддерживает выбор CPU при отсутствии CUDA, но приемлемое время полного прогона на CPU не заявлено.
Создайте отдельное окружение и установите зависимости полного конвейера:
python3.11 -m venv .venv
source .venv/bin/activate
python -m pip install -r backend/requirements-gpu.txt

cd frontend
npm ci
npm run build
cd ..
requirements-gpu.txt содержит зафиксированные CUDA-зависимости. Не устанавливайте поверх него requirements.txt: этот файл предназначен для отдельного окружения тестов серверной логики.
7.2. Запустите Ollama
В отдельном терминале:
export OLLAMA_NO_CLOUD=1
export OLLAMA_NOPRUNE=1
ollama serve
Если локальный сервис уже работает, второй процесс запускать не нужно. Приложение обращается к нему по адресу http://127.0.0.1:11434.
7.3. Загрузите модели заранее
Этот шаг требует интернета. Для Community-1 примите условия доступа на Hugging Face и при необходимости выполните hf auth login в своём окружении. Не добавляйте токены в репозиторий.
В терминале приложения с активированным .venv:
export MEETING_MODELS="$PWD/models"
export HF_HOME="$MEETING_MODELS/hf"
export ASR_MODEL_PATH="$MEETING_MODELS/whisper-large-v3-turbo"
export PYANNOTE_DIARIZATION_MODEL="$MEETING_MODELS/speaker-diarization-community-1"

python - <<'PY'
import json
import os
from pathlib import Path
from huggingface_hub import snapshot_download

models = json.loads(Path("backend/models.json").read_text())
for name in ("asr", "diarization"):
    model = models[name]
    snapshot_download(
        model["repository"],
        revision=model["revision"],
        local_dir=os.environ[model["environment_variable"]],
    )
PY

ollama pull qwen3:8b
Сверьте digest модели в ответе http://127.0.0.1:11434/api/tags с backend/models.json: содержимое изменяемого тега qwen3:8b может отличаться. Казахская дообученная ASR-модель в манифесте — отдельный кандидат; приведённая команда её не загружает.
7.4. Проверьте настройки и запустите приложение
Продолжайте в том же терминале, чтобы сохранить переменные путей к моделям:
export DB_PATH="$PWD/meeting-data/meetings.sqlite"
export STORAGE_DIR="$PWD/meeting-data/files"
export HF_HUB_OFFLINE=1
export TRANSFORMERS_OFFLINE=1
export HF_HUB_DISABLE_TELEMETRY=1
export PYANNOTE_METRICS_ENABLED=0

python backend/scripts/doctor.py

PYTHONPATH=backend uvicorn app.serve:app \
  --host 127.0.0.1 --port 8000 --workers 1
Откройте http://127.0.0.1:8000. Сервер раздаёт собранный интерфейс из frontend/dist.
doctor.py проверяет наличие инструментов, библиотек, артефактов и Qwen в Ollama. Результат ready: true ещё не доказывает успешную загрузку всех моделей или качество распознавания. При ready: false устраните отмеченные проблемы до обработки записи.
Пример настроек — .env.example. Сервер не читает .env автоматически: переменные нужно экспортировать в терминал запуска. При повторном запуске также задайте пути из шага 7.3.
7.5. Только просмотр интерфейса или разработка
Чтобы открыть интерфейс без установки моделей, в отдельном Python-окружении установите backend/requirements.txt, соберите frontend и запустите Uvicorn с DB_PATH и STORAGE_DIR, как выше. Полная обработка аудио без моделей недоступна.
Для разработки интерфейса при работающем backend на порту 8000:
cd frontend
npm run dev -- --host 127.0.0.1
Vite покажет адрес интерфейса и перенаправит запросы /meetings на backend.
7.6. Демо и удалённый доступ
Подтверждённая публичная ссылка на deployed-версию в репозитории не указана. Адрес http://127.0.0.1:8000 относится к локально запущенному приложению и не является публичным демо.
Для доступа к экземпляру на удалённой машине, включая Brev, запустите приложение там, затем на своём компьютере откройте туннель:
ssh -NT -L 8000:127.0.0.1:8000 USER@HOST
Замените USER@HOST данными вашей машины и откройте http://localhost:8000. Если сервер использует другой порт, измените удалённый порт в команде. Доступ к машине и подготовленные модели для такой демонстрации предоставляются отдельно.
8. Как проверить решение
Пользовательский сценарий
Для повторения нужна подготовленная установка из раздела 7 и собственная короткая MP3/WAV-запись. Реальные записи трека в Git не включены: каталог track/ исключён через .gitignore.
Можно записать небольшой тестовый диалог двух участников:
— Айгүл, подготовьте отчёт по аудиту до 30 сентября 2026 года.
— Хорошо, подготовлю отчёт к указанной дате.
— Предлагаю отдельно обсудить обновление оборудования на следующей встрече.
Для этого вымышленного сценария укажите дату встречи 23 сентября 2026 года. Для реальной записи используйте фактическую дату.
- Откройте приложение, загрузите запись, введите дату и участников. Нажмите «Загрузить и обработать».
- Дождитесь статуса «Черновик готов к проверке». При ошибке изучите сообщение; доступен повторный запуск.
- На вкладке «Обзор» проверьте содержание. На вкладке «Стенограмма» прослушайте реплики и исправьте ошибки.
- Во вкладке «Участники» назначьте голосам проверенные имена. Сохраните правки.
- Во вкладке «Поручения» проверьте действие, ответственного, срок, основание и подтверждение. Убедитесь, что предложение обсудить оборудование не стало автоматически подтверждённым поручением.
- Сохраните исправления. Если есть подтверждающая реплика и полномочия участника проверены, отметьте подтверждение поручения и сохраните ещё раз.
- Во вкладке «Экспорт» создайте DOCX. При настроенном LibreOffice проверьте также PDF.
- Обновите страницу по сохранённой ссылке встречи: правки должны остаться. Проверьте, что документ содержит сохранённые данные и обозначен как черновик.
Точный текст ответа модели не гарантируется. Критерии проверки — соответствие записи, проверяемые ссылки на реплики, сохранность правок и корректное разделение проверенных поручений и кандидатов.
Автоматические тесты
В окружении полного конвейера зависимости для этих проверок уже установлены:
PYTHONPATH=backend python -m pytest backend/tests -q
npm test --prefix frontend
npm run build --prefix frontend
Для backend-тестов без весов достаточно отдельного окружения с backend/requirements.txt; для тестов аудио нужен ffmpeg. Тесты используют подмены моделей и проверяют поведение приложения, а не точность распознавания реальной речи.
Полный прогон из командной строки
После подготовки моделей и запуска Ollama можно проверить запись без браузера:
# Подставьте путь к своей записи и её фактическую дату.
export TEST_AUDIO="/absolute/path/meeting.mp3"
export TEST_DATE="2026-09-23"

PYTHONPATH=backend timeout 35m python backend/scripts/brev_smoke.py \
  "$TEST_AUDIO" --meeting-date "$TEST_DATE" \
  --data-dir meeting-data/jury-check \
  --report meeting-data/jury-report.json \
  --result meeting-data/jury-result.json \
  --deny-external-python-network
success: true в отчёте означает технически успешную обработку и получение DOCX. Отчёт также содержит время выполнения, статус, количество реплик и поручений, а при доступном nvidia-smi — показания использования памяти GPU. Полный результат сохраняется отдельно для ручной проверки; он содержит текст записи.
Флаг --deny-external-python-network ограничивает только Python-процесс. Для проверки изоляции также Ollama предусмотрен backend/scripts/offline_smoke.sh; требования и команды приведены в evaluation/README.md.
9. Данные и интеграции
| Источник или компонент | Как используется |
|---|---|
| Пользовательские записи | MP3/WAV, дата встречи и необязательный список участников; аудио и результаты хранятся на машине приложения |
| Hugging Face Hub | Предварительная загрузка снимков Whisper и pyannote; во время обработки используются локальные каталоги |
| Ollama | Локальный запрос POST /api/chat к Qwen по 127.0.0.1:11434; HTTP-прокси игнорируются, перенаправления запрещены |
| FastAPI | Загрузка, запуск обработки, получение результата, правки, воспроизведение аудио, экспорт и удаление встречи через /meetings |
| Материалы оценки | evaluation/cases.json и evaluation/simulated.json: сценарии для ручной оценки и синтетические случаи |
| Brev | Описанная в документации GPU-машина для испытаний; не обязательная зависимость приложения |
Веса, рабочие базы, локальные .env и записи исключены из Git. Обработка не требует облачного API распознавания или внешнего LLM API. Подготовка окружения и загрузка весов требуют сети.
Авторы коммитов
История коммитов
- 2026-09-23 18:15Add files via uploadDimash
- 2026-09-23 18:14Delete docs/image.pngDimash
- 2026-09-23 18:09Update image source in README.mdDimash
- 2026-09-23 18:08Fix image source path for hero imageDimash
- 2026-09-23 18:08Enhance README with project image and titleDimash
- 2026-09-23 18:07adding welcome imageDimash
- 2026-09-23 17:55Update README.mdDimash
- 2026-09-23 17:55Update Jinalys AI branding, tabbed UI and jury READMEAyan
Все коммиты (14)
- 2026-09-23 17:36Restore Transformers stack and record validation resultsAyan
- 2026-09-23 17:10Align model stack with main and update offline validationAyan
- 2026-09-23 17:00Add local model profiles and immutable processing attemptsDimash
- 2026-09-23 16:59Add clean meeting minutes projectAyan
- 2026-09-23 15:36Build local meeting protocol application and document handoffdrakishev
- 2026-09-23 14:02Add initial HackAlemAI challenge dataDimash
Структура репозитория (92 файлов)
.env.example
.gitignore
README.md
backend/app/__init__.py
backend/app/audio.py
backend/app/export.py
backend/app/extract.py
backend/app/main.py
backend/app/process.py
backend/app/review.py
backend/app/serve.py
backend/app/store.py
backend/models.json
backend/requirements-gpu.txt
backend/requirements.txt
backend/scripts/brev_smoke.py
backend/scripts/doctor.py
backend/scripts/evaluate_text.py
backend/scripts/make_synthetic_audio.py
backend/scripts/offline_smoke.sh
backend/tests/conftest.py
backend/tests/test_api.py
backend/tests/test_audio_windows.py
backend/tests/test_end_to_end.py
backend/tests/test_export.py
backend/tests/test_extract.py
backend/tests/test_media.py
backend/tests/test_process.py
backend/tests/test_review.py
backend/tests/test_review_api.py
docs/image.png
docs/implementation-plan.md
docs/research/2026-09-23-model-selection.md
evaluation/2026-09-23-results.md
evaluation/README.md
evaluation/cases.json
evaluation/simulated.json
frontend/index.html
frontend/package-lock.json
frontend/package.json
frontend/src/App.test.tsx
frontend/src/App.tsx
frontend/src/api.test.ts
frontend/src/api.ts
frontend/src/main.tsx
frontend/src/style.css
frontend/src/vite-env.d.ts
frontend/tsconfig.json
frontend/vite.config.ts
variants/llamacpp/.env.example
variants/llamacpp/README.md
variants/llamacpp/SNAPSHOT.md
variants/llamacpp/backend/app/__init__.py
variants/llamacpp/backend/app/audio.py
variants/llamacpp/backend/app/export.py
variants/llamacpp/backend/app/extract.py
variants/llamacpp/backend/app/main.py
variants/llamacpp/backend/app/model_artifacts.py
variants/llamacpp/backend/app/process.py
variants/llamacpp/backend/app/review.py
variants/llamacpp/backend/app/serve.py
variants/llamacpp/backend/app/store.py
variants/llamacpp/backend/models.json
variants/llamacpp/backend/requirements-gpu.txt
variants/llamacpp/backend/requirements.txt
variants/llamacpp/backend/scripts/brev_smoke.py
variants/llamacpp/backend/scripts/doctor.py
variants/llamacpp/backend/scripts/evaluate_text.py
variants/llamacpp/backend/scripts/make_synthetic_audio.py
variants/llamacpp/backend/scripts/offline_smoke.sh
variants/llamacpp/backend/tests/conftest.py
variants/llamacpp/backend/tests/test_api.py
variants/llamacpp/backend/tests/test_audio_windows.py
variants/llamacpp/backend/tests/test_end_to_end.py
variants/llamacpp/backend/tests/test_export.py
variants/llamacpp/backend/tests/test_extract.py
variants/llamacpp/backend/tests/test_media.py
variants/llamacpp/backend/tests/test_model_adapters.py
variants/llamacpp/backend/tests/test_process.py
variants/llamacpp/backend/tests/test_review.py
variants/llamacpp/backend/tests/test_review_api.py
variants/llamacpp/docs/agents/domain.md
variants/llamacpp/docs/agents/issue-tracker.md
variants/llamacpp/docs/agents/triage-labels.md
variants/llamacpp/docs/implementation-plan.md
variants/llamacpp/docs/research/2026-09-23-model-selection.md
variants/llamacpp/docs/superpowers/plans/2026-09-23-meeting-minutes-mvp.md
variants/llamacpp/docs/superpowers/specs/2026-09-23-live-preview-dashboard-design.md
variants/llamacpp/docs/superpowers/specs/2026-09-23-meeting-minutes-mvp-design.md
variants/llamacpp/evaluation/README.md
variants/llamacpp/evaluation/cases.json
variants/llamacpp/evaluation/simulated.json
Обсуждение 0 комментариев
Войдите, чтобы комментироватьПока нет комментариев — будьте первым.