О проекте
Команда: bekbalbek
Кейс HackAlem.ai: Инновации — Самрук-Казына
Стадия: Доведённый продукт
Задача кейса: «Хаттама»: протокол и поручения по аудиозаписи совещания (каз./рус./смешанная речь)
Суть
Локальный помощник секретаря: из записи совещания (RU/KK/смешанная речь) делает стенограмму с диаризацией и проект протокола с поручениями, ответственными и сроками, привязанными к цитатам. Подтверждённый протокол экспортируется в PDF и DOCX.
Как устроено
ffmpeg приводит запись к 16 kHz mono, Silero VAD выделяет речь, язык определяется по окнам. RU/EN-окна распознаёт faster-whisper large-v3-turbo, KK-окна дообученная казахская Whisper, на выходе таймкоды слов. Диаризация на CPU: pyannote segmentation-3.0 и ERes2Net через sherpa-onnx, затем совмещение слов и говорящих, данные хранятся в PostgreSQL. Агент (OpenAI Agents SDK поверх локальной Qwen3.5-4B в Ollama) читает встречу инструментами get_meeting и read_transcript и возвращает JSON протокола. Сервер проверяет цитаты и метки говорящих, пересчитывает относительные сроки от даты встречи. Человек подтверждает проект, экспорт через ReportLab и python-docx.
Ключевые решения
- Silero VAD
- per-window language routing
- speaker diarization
- word-level alignment
- tool calling
- citation verification
- relative deadline parsing
- outbound network guard
Метрики
Все группы поручений из эталонных протоколов найдены на двух записях организаторов (10/10 и 6/6)
Особенности
Полностью локальный стек: ASR, диаризация и LLM работают на машине пользователя, исходящие соединения блокирует guard, счётчик блокировок виден в /api/health. Язык определяется по окнам, и запись маршрутизируется между русской и казахской Whisper. Каждое поручение связано с сегментом стенограммы и говорящим. Точность оценена по эталонным протоколам организаторов.
Стек
Python · FastAPI · PostgreSQL · SQLAlchemy · Alembic · OpenAI Agents SDK · CTranslate2 · ONNX Runtime · sherpa-onnx · React · TypeScript · Vite · Docker Compose · ReportLab · python-docx
Модели
faster-whisper-large-v3-turbo · kazakh-whisper-large-v3-turbo · Qwen3.5-4B (Ollama) · Qwen3-4B-Instruct-2507 · pyannote segmentation-3.0 · 3D-Speaker ERes2Net · Silero VAD
Проект создан за 5 часов на финале хакатона HackAlem.ai (23 сентября 2026, Астана). Код — BAITC-Hacks/hack-1c29d967-bekbalbek.
README
README.mdProtokol
Локальный помощник для секретаря совещания и руководителя: превращает запись встречи в стенограмму с говорящими и проект протокола — саммари, решения, поручения, ответственные и сроки. Каждое поручение связано с фрагментом стенограммы. Человек проверяет проект, подтверждает его и скачивает PDF или DOCX. Аудио и текст обрабатываются на машине пользователя.
Что реализовано
| Требование | Статус | Проверка |
|---|---|---|
| Распознавание речи | ✅ Загрузка аудио/видео, локальная обработка, таймкоды слов | tests/speech/test_asr.py, POST /api/domain/meetings/{id}/transcribe |
| Русский язык | ✅ Проверен на двух записях организаторов; остаются ошибки имён | Аудит |
| Казахский язык | ✅ Отдельная дообученная модель Whisper large-v3-turbo для казахского; ограничение: короткие казахские реплики внутри русской речи иногда распознаются как русские (см. разбор смешанной речи) | tests/speech/test_asr.py, разбор смешанной речи |
| Смешанная RU/KK-речь | ⚠️ Выбор языка по окнам; переключение внутри предложения не решено | app/speech/asr.py |
| Поручения, ответственные, сроки | ✅ Все группы поручений из эталонных протоколов найдены на обеих записях организаторов (10/10 и 6/6); отдельные ошибки содержания перечислены в аудите | tests/domain/test_service.py, аудит |
| Диаризация и привязка к людям | ✅ Говорящие разделены, каждое поручение привязано к говорящему (owner_speaker_id) и к цитате из стенограммы (source_segment_ids); имена говорящих задаются в интерфейсе, автоматической идентификации по голосу нет | tests/speech/test_diarize.py, tests/speech/test_align.py |
| PDF/DOCX | ✅ Экспорт подтверждённого протокола с кириллицей, таблицей и стенограммой | tests/domain/test_exports.py, Docker-проверка |
Пути app/ и tests/ в таблице относятся к backend/. Статусы поручений в интерфейсе сохраняются только в текущем браузере и не изменяют PDF/DOCX.
Скриншоты
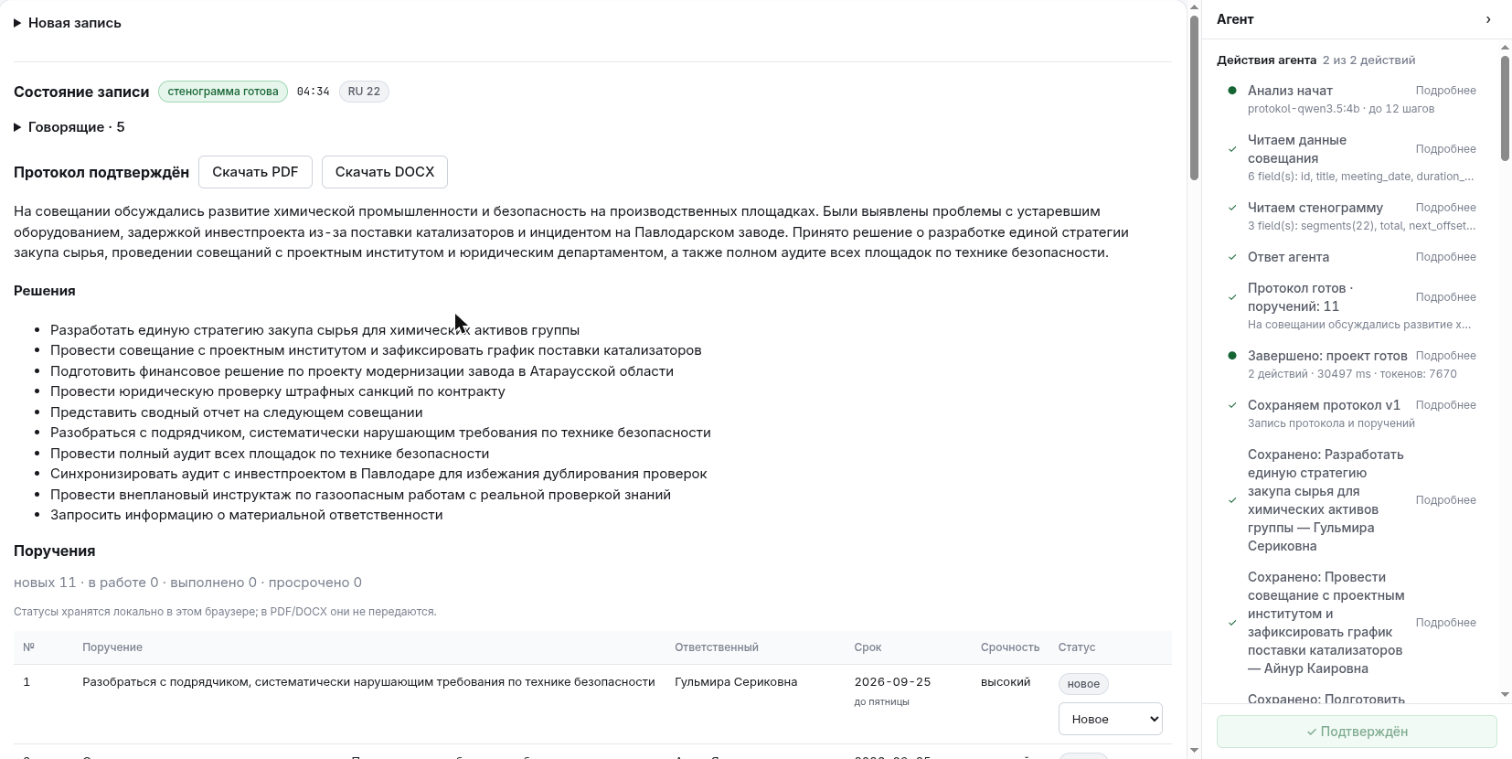
01 — Подтверждённый протокол с кнопками экспорта PDF и DOCX.
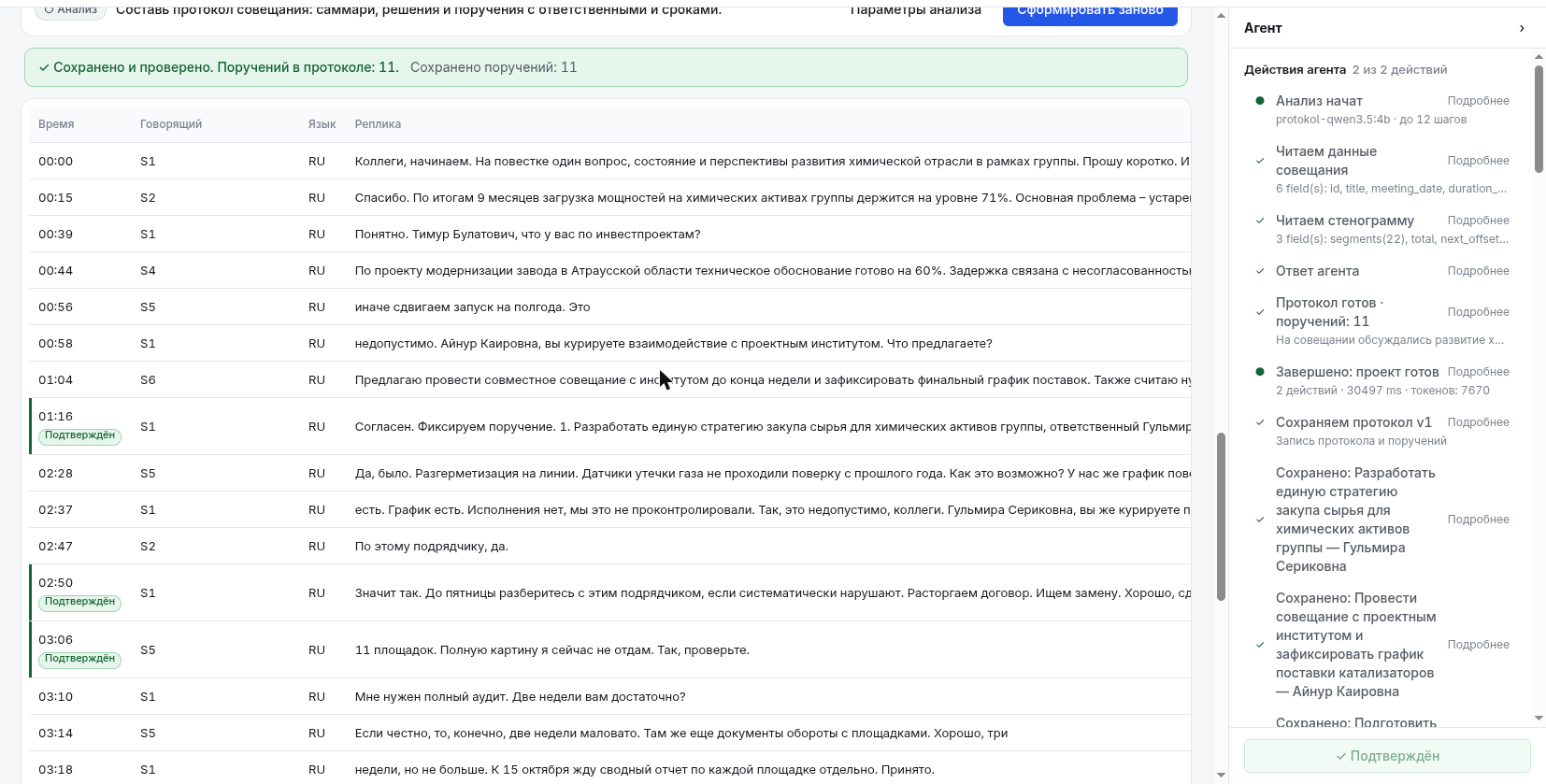
02 — Стенограмма с подтверждающими фрагментами и шагами агента.
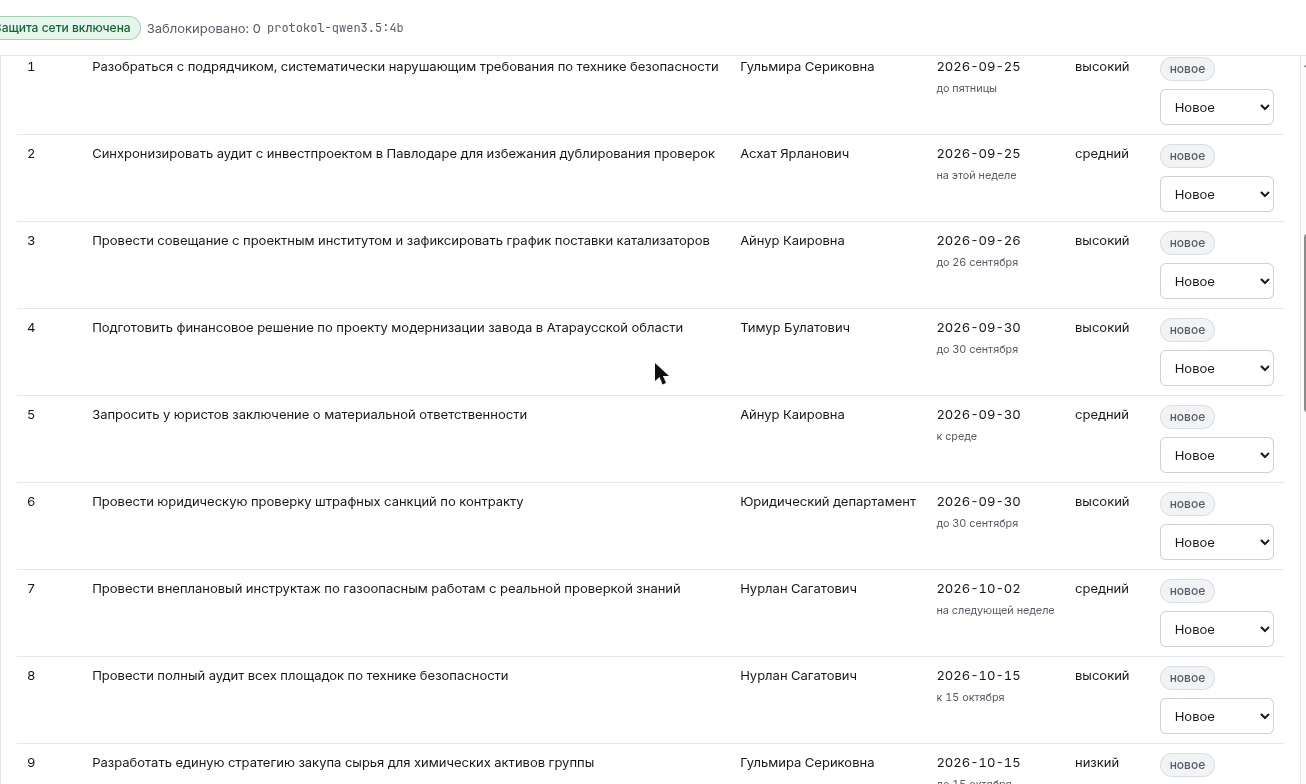
03 — Доска статусов поручений с индикатором локальной работы и сетевой защиты.
Как это работает
Запись → ffmpeg, 16 kHz mono → Silero VAD → определение языка окна
       → RU/EN Whisper turbo или Kazakh Whisper → таймкоды слов
       → диаризация на CPU → совмещение слов и говорящих → PostgreSQL
       → инструменты get_meeting / read_transcript → проект протокола
       → проверка цитат и сроков → подтверждение человеком → PDF / DOCX
В режиме Qwen агент читает встречу и стенограмму через инструменты, затем возвращает структурированный JSON. Сервер проверяет, что цитаты принадлежат встрече и прочитаны в текущем запуске, сверяет метки говорящих и рассчитывает распознанные относительные сроки от даты встречи. Это не доказывает смысловую правильность каждого поля — проект требует просмотра.
Трассировка SDK отключена. Модели речи открываются только с локального диска. Защита исходящих соединений и счётчик блокировок отображаются в /api/health. Это прикладная защита Python, а не независимый сетевой аудит; соединение с локальной базой Docker необходимо для работы приложения.
Технологии и модели
| Компонент | Назначение / размер на диске | Лицензия и источник |
|---|---|---|
deepdml/faster-whisper-large-v3-turbo-ct2 | RU/EN ASR, около 1,6 GiB | MIT |
shyngys879/kazakh-whisper-large-v3-turbo, локальный CT2 | Казахский ASR, около 782 MiB | Apache-2.0 |
| pyannote segmentation-3.0 ONNX | Сегментация голосов; вместе с ERes2Net около 46 MiB | MIT, веса |
| 3D-Speaker ERes2Net ONNX | Представления голосов и кластеризация | Apache-2.0 |
| Silero VAD ONNX | Детектор речи, около 632 KiB | MIT |
| Qwen3.5-4B через Ollama | Живое извлечение протокола, 3,4 GB | Apache-2.0 |
| Qwen3-4B-Instruct-2507 Q4_K_M | Дополнительный локальный вариант, 2,5 GB | Apache-2.0 |
backend/scripts/get_models.sh получает RU-модель с Hugging Face, VAD и ONNX-модели диаризации из публичных релизов sherpa-onnx. make models скачивает публичные модели и конвертирует казахскую модель из Hugging Face в CT2. Веса не входят в Git. Лицензия весов pyannote — MIT; среды sherpa-onnx — Apache-2.0.
Основные библиотеки: Python 3.12 (PSF); FastAPI, Pydantic, OpenAI Agents SDK, faster-whisper, CTranslate2, ONNX Runtime, SQLAlchemy, Alembic, python-docx (MIT); asyncpg и sherpa-onnx (Apache-2.0); ReportLab (BSD); React и Vite (MIT), TypeScript (Apache-2.0). PostgreSQL — PostgreSQL License, Ollama — MIT. Лицензия ffmpeg зависит от сборки (LGPL/GPL). Шрифты DejaVu и их уведомление находятся в backend/app/domain/fonts/. Код Protokol — MIT; лицензии моделей и зависимостей действуют отдельно. Версии закреплены в backend/uv.lock и frontend/pnpm-lock.yaml.
Архитектура
FastAPI обслуживает загрузку, обработку и экспорт; PostgreSQL хранит встречи, сегменты, говорящих, проекты и подтверждения. React показывает запись, стенограмму, доказательства и результат. DomainModule связывает обработку встреч с исполнением агента, а DomainAdapter — данные протокола с интерфейсом. Подробности: архитектура, API, локальный Qwen.
Установка и запуск
Два пути: Docker — воспроизводимая демонстрация без LLM; dev — живой локальный Qwen. В обоих распознавание аудио настоящее и требует весов речи. LLM-путь требует Ollama на хосте и не контейнеризирован.
Веса речи
Установите uv и Python 3.12, затем из корня репозитория выполните:
make install
make models
make models скачивает публичные модели и конвертирует shyngys879/kazakh-whisper-large-v3-turbo из Hugging Face в CT2 int8, если казахских весов ещё нет. Для конвертации нужны около 4 GB Python-пакетов и несколько минут; команда конвертации сегодня не была повторно проверена на чистой машине, проверен только синтаксис скрипта. Готовые локальные веса также можно скопировать в backend/models/. Структура полного комплекта:
backend/models/
  ru-turbo-ct2/       model.bin, config.json, tokenizer.json,
                     preprocessor_config.json, vocabulary.json
  kk-turbo-ct2/       те же пять файлов
  vad/silero_vad.onnx
  diarization/sherpa-onnx-pyannote-segmentation-3-0/model.onnx
  diarization/3dspeaker_speech_eres2net_base_sv_zh-cn_3dspeaker_16k.onnx
Полный комплект весов занимает около 2,4 GiB; установка требует интернета, подготовленные модели при обработке сеть не используют. Если казахская модель отсутствует, приложение один раз предупреждает при её первом использовании в обработке записи и направляет казахские окна в русскую многоязычную модель с низким качеством. /api/health показывает kazakh_model_present: false; models_present: true означает наличие RU-модели, VAD и диаризации и не требует казахских весов. Если конвертация не завершилась, уже скачанных RU/VAD/диаризации достаточно для русскоязычных образцов.
Docker: без Ollama
Нужны Docker Engine с Compose, make, curl, свободные порты 5433 и 8080. Для CLI-проверки нужны Bash, jq и od (coreutils). При первой сборке скачиваются образы и зависимости; требуется место для весов и Python/CUDA-библиотек, даже при CPU-обработке.
cp .env.example .env
mkdir -p backend/media
# До запуска выполните make install models или скопируйте готовые веса в backend/models/.
OPENAI_MODEL=scripted:auto make stack
curl -fsS http://localhost:8080/api/health
Откройте http://localhost:8080/#/app. Ожидается model: scripted:auto, models_present: true, provenance.enabled: true. Compose монтирует локальные models, media, samples; ASR работает на CPU. Для загрузки/конвертации весов через make models на хосте нужны uv и Python 3.12; конвертация требует около 4 GB пакетов и нескольких минут и сегодня не перепроверялась на чистой машине. Обе записи организаторов русскоязычные и работают без казахской модели; тогда kazakh_model_present: false, а казахские окна обрабатываются RU-моделью с низким качеством. Адрес http://localhost:11434/v1 нужен для проверки конфигурации при запуске; scripted-режим к нему не обращается. Явное значение OPENAI_MODEL исключает влияние настроек оболочки. Создание backend/media до запуска контейнера сохраняет права текущего пользователя для файлов CLI-проверки.
Dev: локальный Qwen
Dev-путь проверен на Linux (Arch) и требует CUDA-пакетов из pyproject; на macOS используйте Docker-путь, он работает без GPU.
Нужны Python 3.12, uv, Node 22.13+, pnpm, ffmpeg, Docker для PostgreSQL и Ollama на этой же машине. Установите в Ollama qwen3.5:4b, затем:
make install
cd frontend && pnpm install --frozen-lockfile && cd ..
make demo
make llm
OPENAI_MODEL=protokol-qwen3.5:4b make api
# В другом терминале:
make web
Откройте http://localhost:5173/#/app. make llm создаёт локальное имя protokol-qwen3.5:4b с контекстом 16 384 токена, переиспользуя установленные веса. Если исходной модели ещё нет: ollama pull qwen3.5:4b (загрузка весов, не передача аудио или текста). Подробности — в LOCAL_LLM.md.
STT_DEVICE=auto выбирает CUDA при наличии, иначе CPU; для явного выбора задайте STT_DEVICE=cpu или STT_DEVICE=cuda перед make api. CPU использует int8. На машине с 6 GB VRAM ASR и LLM обрабатываются последовательно.
Как проверить
Сначала: демонстрация без языковой модели
- Запустите Docker-командой выше; Ollama не нужен.
- Откройте
http://localhost:8080/#/app→ «Новая запись», выберитеbackend/samples/sovechanie_2.mp3, укажите название и дату2026-09-23, нажмите «Загрузить». - Нажмите «Транскрибировать» и дождитесь готовности. На проверенной машине CPU занял 472 секунды (7 мин 52 с). Проверьте стенограмму; при необходимости задайте имена в разделе «Говорящие» до формирования проекта.
- Нажмите «Сформировать протокол», просмотрите цитаты, затем «Подтвердить протокол» → «Скачать PDF» или «Скачать DOCX».
Scripted-режим выбирает не более трёх цитат с распознанным сроком, без LLM. В проверенном Docker-прогоне записи №2 получилась одна строка, статус verified, PDF на две страницы. Это проверка всей цепочки, но не полноты извлечения Qwen. Результаты.
CLI-эквивалент загружает новую запись, не сбрасывая существующие встречи:
API=http://localhost:8080 make smoke
Ответы, времена, PDF и DOCX сохраняются под backend/media/verification/. Отдельные curl-запросы — в API.md.
Затем: живая модель
Выполните make llm, запустите dev API с OPENAI_MODEL=protokol-qwen3.5:4b, проверьте /api/health на порту 8000 и повторите шаги в интерфейсе на 5173. CLI: API=http://localhost:8000 make smoke. Проверенный Qwen-прогон записи №1 сформировал 11 строк за 30,5 секунды после готовой стенограммы. Сохранены оба состояния одного запуска: JSON предложения содержит detail.run.status = proposed (имя файла не означает подтверждение), а полный RunDetail после подтверждения, повторно полученный через API после восстановления исходной БД, содержит run.status = verified, application.status = verified и проверки сохранения в application.verification. Предложение используется для оценки извлечения; второй файл подтверждает применение. Файлы этого подтверждённого запуска: PDF и DOCX. Экспорт дополнительно проверен в Docker-сценарии выше. Число строк может меняться при новом запуске.
Ручная оценка двух организаторских записей: 10/10 и 6/6 групп поручений имеют соответствие, создано 11 и 8 строк. Это покрытие групп, не «100% точность»: ошибки перечислены в accuracy-summary.md.
python3 evaluation/organizer/check_samples.py --source-dir evaluation/organizer/source
Проверка исходников дала PASS для обеих записей: четыре размера/SHA-256 совпали, 10 и 6 групп совпали с таблицами DOCX. Она проверяет происхождение файлов и эталонные строки, а не качество ASR/Qwen. Исходные протоколы не подаются модели.
Для записи №1 длительностью 274,25 с речевой конвейер занял 86,726 с на GPU (≈87 с) и 522,162 с на CPU (≈522 с). GPU — RTX 3060 Laptop 6 GB; CPU — Ryzen 5 5600H. Время включает загрузку моделей, VAD, ASR, диаризацию и совмещение, исключает генерацию протокола, БД и экспорт. Диаризация всегда на CPU. Измерения.
cd backend
uv run pytest -q
uv run ruff check .
cd ../frontend
pnpm lint
pnpm build
Последняя проверка backend: 200 passed; Ruff и ESLint чистые. Предыдущий прогон дал 222 passed; после удаления Docker-подключения к LLM удалены и 23 соответствующие проверки, затем добавлена проверка работы без казахских весов. Тестам API нужна PostgreSQL на 5433 (отдельная agent_workspace_test); тесты с маркером models требуют локальных весов и без них пропускаются. Проверка без ASR: uv run pytest -q -m 'not models'.
Проверка чистого клона — выполнена
23 сентября проверен коммит 94f6888 в /tmp/protokol-check: отдельный Docker-проект protokol-check, новая база protokol-check_pgdata, скопированные локальные веса. make stack завершился успешно; health показал scripted:auto, models_present: true, включённую защиту и ноль блокировок. Новый smoke-скрипт загрузил запись №2, распознал её за 455 секунд, подтвердил одно поручение (verified) и скачал PDF (54 281 байт, 2 страницы) и DOCX (39 681 байт, корректный архив). Затем git pull --rebase, pnpm install --frozen-lockfile, pnpm build и pnpm lint прошли в клоне. Это полный прогон из чистого checkout и новой БД; веса и кэш Docker были локальными.
При повторной проверке на той же машине сначала остановите первый стек командой docker compose --profile app down (без удаления томов): контейнеры и порты двух экземпляров совпадают. Из чистого клона с размещёнными весами выполните:
cp .env.example .env
mkdir -p backend/media
COMPOSE_PROJECT_NAME=protokol-check OPENAI_MODEL=scripted:auto make stack
API=http://localhost:8080 make smoke
Данные и интеграции
Записи sovechanie_1.mp3 и sovechanie_2.mp3 предоставлены организаторами. Два смешанных RU/KK/EN-файла записаны командой. Загруженные записи остаются в backend/media/, результаты — в локальной PostgreSQL. Облачных API для аудио и текста нет; СЭД, почта, Teams и Zoom не подключены. Установка зависимостей и публичных весов требует интернета, обработка — нет. blocked_external_connections: 0 означает отсутствие зарегистрированных блокировок, а не доказательство отсутствия любого сетевого трафика.
Ограничения
Интерфейс не предупреждает об отсутствии казахской модели; признак kazakh_model_present виден только в /api/health.
- При аудите обнаружены один неверный исполнитель, один дубликат, искажённые распознаванием имена, некоторые цитаты на другое высказывание и пропущенное позднее изменение срока. Проект требует проверки этих полей.
- Короткие казахские реплики иногда маршрутизируются в русскую модель; возможна потеря регистра и пунктуации. Переключение языка внутри фразы и наложение голосов обрабатываются ненадёжно.
- Диаризация пакетная, не потоковая; возможны объединённые реплики и лишние метки. Имена говорящих появляются только после ручного переименования в UI. Ответственный из поручения не используется для автоматического называния голоса.
- Сроки считаются от указанной даты встречи. Для формулировок только с неделей используется соглашение о пятнице; неразобранная дата остаётся пустой. Позднее уточнение не всегда заменяет ранний срок.
- У 4B-модели ограничен контекст; длинная встреча может не поместиться. Повреждённый JSON отклоняется. Приложение формирует проект, а не юридически выверенный итог.
- Статусы поручений локальны для браузера. Редактирование поручений через API и совместные статусы не реализованы. Подтверждённая запись защищена от повторной транскрипции.
- WER и DER не заявляются: нет вручную проверенной временной разметки, а протоколы организаторов местами расходятся с записью. Приложение проверено как локальная демонстрация, без многопользовательской авторизации.
Дорожная карта
Улучшить сохранение финальных сроков, устранение повторов и смысловую проверку цитат; собрать размеченный набор казахской и смешанной речи; добавить серверные статусы и редактирование поручений. Следующие интеграции: СЭД, напоминания и рассылка ответственным, голосовая идентификация с согласия участников, Teams/Zoom. Эти функции пока не реализованы.
Авторы коммитов
История коммитов
- 2026-09-23 17:46README: platform note and Kazakh model flagBaltabay Zhanybek
- 2026-09-23 17:38Frontend: hero demo stage fits the action-item sceneBaltabay Zhanybek
- 2026-09-23 17:33Models: Kazakh model conversion and Russian fallback when absentBaltabay Zhanybek
- 2026-09-23 17:23README: requirement status reflects implemented scopeBaltabay Zhanybek
- 2026-09-23 17:21Docs: screenshots and confirmed protocol exportsBaltabay Zhanybek
- 2026-09-23 17:16Verified clean Docker clone and confirmed Qwen evidenceBaltabay Zhanybek
- 2026-09-23 16:55README, license, docs and cleanup for ProtokolBaltabay Zhanybek
- 2026-09-23 16:40Docker: scripted demo stack with local speech modelsBaltabay Zhanybek
Все коммиты (22)
- 2026-09-23 16:12Frontend: keep meeting runs attached and complete protocol reviewrashidulybekzat
- 2026-09-23 16:06Local LLM: 16k-context model alias, speaker validation, local model guideBaltabay Zhanybek
- 2026-09-23 15:44Frontend: Protokol Russian interface, offline indicators and browser checksrashidulybekzat
- 2026-09-23 15:31Frontend: upload, transcription polling, speaker names, exports and local task statusesrashidulybekzat
- 2026-09-23 15:22Frontend: meeting protocol adapter, endpoint helpers and fixturesrashidulybekzat
- 2026-09-23 15:18Export confirmed protocol as PDF and DOCX with Cyrillic fontsBaltabay Zhanybek
- 2026-09-23 15:17Protocol agent: transcript evidence, validated actions and working scripted confirmationBaltabay Zhanybek
- 2026-09-23 14:53test: add organizer meeting references and local verificationrashidulybekzat
- 2026-09-23 14:45Meetings: upload, background transcription, speaker attribution and transcript APIBaltabay Zhanybek
- 2026-09-23 14:44Speech: speaker alignment and conservative RU/KK spoken deadlinesBaltabay Zhanybek
- 2026-09-23 14:44Speech: local RU/KK recognition, language windows, word timestamps and diarizationBaltabay Zhanybek
- 2026-09-23 14:34Local model runtime: provenance guard, CUDA preload, Ollama routing, model install scriptBaltabay Zhanybek
- 2026-09-23 13:59Add project scaffoldingBaltabay Zhanybek
- 2026-09-23 13:18first commitrashidulybekzat
Структура репозитория (225 файлов)
.env.example
.github/workflows/ci.yml
.gitignore
LICENSE
Makefile
README.md
backend/.dockerignore
backend/.python-version
backend/Dockerfile
backend/alembic.ini
backend/alembic/README
backend/alembic/env.py
backend/alembic/script.py.mako
backend/alembic/versions/20260923_e0ab44d8ac4d_initial_schema.py
backend/alembic/versions/20260923_protokol_domain.py
backend/app/__init__.py
backend/app/api/__init__.py
backend/app/api/deps.py
backend/app/api/health.py
backend/app/api/middleware.py
backend/app/api/runs.py
backend/app/api/schemas.py
backend/app/boot.py
backend/app/config.py
backend/app/core/__init__.py
backend/app/core/agent_runtime.py
backend/app/core/apply_service.py
backend/app/core/context.py
backend/app/core/contracts.py
backend/app/core/errors.py
backend/app/core/events.py
backend/app/core/llm.py
backend/app/core/read_models.py
backend/app/core/run_registry.py
backend/app/core/run_service.py
backend/app/core/serialization.py
backend/app/core/services.py
backend/app/core/status.py
backend/app/core/tooling.py
backend/app/db/__init__.py
backend/app/db/base.py
backend/app/db/engine.py
backend/app/db/models.py
backend/app/domain/__init__.py
backend/app/domain/api.py
backend/app/domain/examples.py
backend/app/domain/exports.py
backend/app/domain/fonts/DejaVuSans-Bold.ttf
backend/app/domain/fonts/DejaVuSans.ttf
backend/app/domain/fonts/LICENSE
backend/app/domain/instructions.py
backend/app/domain/models.py
backend/app/domain/repo.py
backend/app/domain/schemas.py
backend/app/domain/scripts.py
backend/app/domain/seed.py
backend/app/domain/service.py
backend/app/domain/tools.py
backend/app/domain/transcribe_job.py
backend/app/main.py
backend/app/speech/__init__.py
backend/app/speech/align.py
backend/app/speech/asr.py
backend/app/speech/audio.py
backend/app/speech/cuda.py
backend/app/speech/deadlines.py
backend/app/speech/diarize.py
backend/app/speech/guard.py
backend/evals/README.md
backend/evals/__init__.py
backend/evals/results/.gitkeep
backend/evals/runner.py
backend/evals/scenarios.py
backend/pyproject.toml
backend/samples/README.md
backend/samples/mixed-ru-kk-en-1.m4a
backend/samples/mixed-ru-kk-en-2.m4a
backend/samples/sovechanie_1.mp3
backend/samples/sovechanie_2.mp3
backend/scripts/__init__.py
backend/scripts/configure_ollama.sh
backend/scripts/entrypoint.sh
backend/scripts/get_models.sh
backend/scripts/seed.py
backend/scripts/smoke.sh
backend/tests/__init__.py
backend/tests/api/__init__.py
backend/tests/api/conftest.py
backend/tests/api/test_api.py
backend/tests/api/test_upload_limit.py
backend/tests/conftest.py
backend/tests/core/__init__.py
backend/tests/core/conftest.py
backend/tests/core/scripted.py
backend/tests/core/test_apply_service.py
backend/tests/core/test_contracts.py
backend/tests/core/test_events.py
backend/tests/core/test_llm_routing.py
backend/tests/core/test_run_service.py
backend/tests/core/test_tooling.py
backend/tests/domain/__init__.py
backend/tests/domain/conftest.py
backend/tests/domain/test_audio_paths.py
backend/tests/domain/test_exports.py
backend/tests/domain/test_meetings_api.py
backend/tests/domain/test_schemas.py
backend/tests/domain/test_scripts.py
backend/tests/domain/test_service.py
backend/tests/domain/test_tools.py
backend/tests/fixtures/meeting_10s.wav
backend/tests/speech/__init__.py
backend/tests/speech/conftest.py
backend/tests/speech/test_align.py
backend/tests/speech/test_asr.py
backend/tests/speech/test_deadlines.py
backend/tests/speech/test_diarize.py
backend/tests/speech/test_guard.py
backend/uv.lock
docker-compose.yml
docs/API.md
docs/ARCHITECTURE.md
docs/FRONTEND_HANDOFF.md
docs/LOCAL_LLM.md
docs/SUBMISSION.md
docs/screenshots/01-protocol-confirmed.png
docs/screenshots/02-transcript-evidence-timeline.png
docs/screenshots/03-status-board.png
evaluation/docker-smoke.json
evaluation/mixed-language-1.json
evaluation/mixed-language-2.json
evaluation/mixed-language.md
evaluation/organizer/README.md
evaluation/organizer/accuracy-2-meeting.json
evaluation/organizer/accuracy-2-run.json
evaluation/organizer/accuracy-meeting-1.md
evaluation/organizer/accuracy-meeting-2.md
evaluation/organizer/accuracy-summary.md
evaluation/organizer/accuracy-transcript-1.json
evaluation/organizer/accuracy-transcript-2.json
evaluation/organizer/accuracy-transcript-meeting-1.json
evaluation/organizer/accuracy-transcription.md
evaluation/organizer/check_samples.py
evaluation/organizer/meeting-2-deadlines-second-pass.txt
evaluation/organizer/meeting-2-disputed-deadlines.wav
evaluation/organizer/qwen-live-verified.json
evaluation/organizer/references.json
evaluation/organizer/results/qwen-live-confirmed.json
evaluation/organizer/results/qwen-live-protocol.docx
evaluation/organizer/results/qwen-live-protocol.pdf
evaluation/organizer/source-check.json
evaluation/organizer/source/Протокол_совещания№1.docx
evaluation/organizer/source/Протокол_совещания№2.docx
evaluation/organizer/source/Совещание №1.mp3
evaluation/organizer/source/Совещание №2.mp3
evaluation/performance/sample1-cpu.json
evaluation/performance/summary.json
frontend/.dockerignore
frontend/.gitignore
frontend/.nvmrc
frontend/Dockerfile
frontend/README.md
frontend/e2e/meeting-flow.spec.ts
frontend/eslint.config.js
frontend/index.html
frontend/nginx.conf
frontend/package.json
frontend/playwright.config.ts
frontend/pnpm-lock.yaml
frontend/pnpm-workspace.yaml
frontend/src/App.tsx
frontend/src/api/client.test.ts
frontend/src/api/client.ts
frontend/src/api/types.ts
frontend/src/config.ts
frontend/src/dashboard/Dashboard.test.tsx
frontend/src/dashboard/Dashboard.tsx
frontend/src/dashboard/components/AgentPanel.tsx
frontend/src/dashboard/components/ApplyPanel.tsx
frontend/src/dashboard/components/CaseHeader.tsx
frontend/src/dashboard/components/CaseList.tsx
frontend/src/dashboard/components/ChangeList.tsx
frontend/src/dashboard/components/ChangesTable.tsx
frontend/src/dashboard/components/EvidenceDrawer.test.tsx
frontend/src/dashboard/components/EvidenceDrawer.tsx
frontend/src/dashboard/components/NeedsInputForm.test.tsx
frontend/src/dashboard/components/NeedsInputForm.tsx
frontend/src/dashboard/components/StartCard.tsx
frontend/src/dashboard/components/StatusCards.test.tsx
frontend/src/dashboard/components/StatusCards.tsx
frontend/src/dashboard/components/Timeline.tsx
frontend/src/dashboard/components/TopBar.test.tsx
frontend/src/dashboard/components/TopBar.tsx
frontend/src/dashboard/components/Workspace.tsx
frontend/src/dashboard/dashboard.css
frontend/src/dashboard/model/adapter.ts
frontend/src/dashboard/model/changes.ts
frontend/src/dashboard/model/phase.test.ts
frontend/src/dashboard/model/phase.ts
frontend/src/dashboard/model/runs.test.ts
frontend/src/dashboard/model/runs.ts
frontend/src/dashboard/model/timeline.test.ts
frontend/src/dashboard/model/timeline.ts
frontend/src/dashboard/route.test.ts
frontend/src/dashboard/route.ts
frontend/src/dashboard/useRun.test.tsx
frontend/src/dashboard/useRun.ts
frontend/src/domain/MeetingPanel.test.tsx
frontend/src/domain/MeetingPanel.tsx
frontend/src/domain/api.test.ts
frontend/src/domain/api.ts
frontend/src/domain/meeting-panel.css
frontend/src/domain/protokol.test.ts
frontend/src/domain/protokol.ts
frontend/src/domain/status.ts
frontend/src/landing/Landing.test.tsx
frontend/src/landing/Landing.tsx
frontend/src/landing/landing.css
frontend/src/main.tsx
frontend/src/styles/tokens.css
frontend/src/test/fakeApi.ts
frontend/src/test/fakeEventSource.ts
frontend/src/test/fixtures.ts
frontend/src/test/setup.ts
frontend/tsconfig.json
frontend/vite.config.ts
Обсуждение 0 комментариев
Войдите, чтобы комментироватьПока нет комментариев — будьте первым.