О проекте
Команда: 1718
Кейс HackAlem.ai: Телеком — Beeline
Стадия: Доведённый продукт
Задача кейса: Агент, который решает, каким абонентам какой тариф предложить (чистый прирост ARPU)
Суть
Tariflow — агент планирования тарифных кампаний Beeline: строит гипотезы, проверяет их пилотами и собирает план из 1–10 кампаний в пределах бюджета и лимита контактов. Для маркетолога есть веб-интерфейс с отчётом и ответами на RU/KK.
Как устроено
Agent.act(env) строит гипотезы по сегментам ARPU, данных, звонков и текущему тарифу (candidate_model.py). Историю переходов переносит осторожно: сглаживает и ограничивает её вклад пятью псевдонаблюдениями. Затем проводит до 20 пилотов через env.run_pilot (10–200 абонентов) и после каждого обновляет оценки. Кампания попадает в план только после двух пилотов на её канале. Из оценки эффекта вычитаются стоимость контактов и эвристический запас неопределённости. Итоговый набор выбирается ограниченным перебором или жадно с учётом бюджета 100 000, лимита 15 000 контактов и пересечений аудиторий. Опциональный LLM-советник OpenAI отвечает на вопросы по отчёту только на основе проверенных источников.
Ключевые решения
- pilot-based exploration
- pseudo-observation smoothing
- uncertainty penalty
- bounded combinatorial search
- greedy selection
- holdout quality experiments
Метрики
Net 685 149,52 у.е. на seed 42; 3 финальные кампании и 20 пилотов; расход 46 598 из 100 000 у.е.; 5 606 из 15 000 контактов; 2 903 уникальных абонента
Особенности
История с другой выборки переносится осторожно, через ограниченные псевдонаблюдения. Для включения кампании требуются два пилота на её канале. Экспериментальные политики проверили на holdout и не включили, потому что преимущества они не дали. submission.csv воспроизводится официальным evaluator.
Стек
Python · pandas · NumPy · JavaScript (web) · PowerShell · Node.js test runner
Модели
OpenAI
Проект создан за 5 часов на финале хакатона HackAlem.ai (23 сентября 2026, Астана). Код — BAITC-Hacks/hack-25081c1e-1718.
README
README.mdTariflow
Агент планирования тарифных маркетинговых кампаний: исследует аудиторию, проверяет гипотезы пилотами и формирует план в пределах бюджета и лимита контактов.
Проект решает Beeline Tariff Marketing Campaigns Case: 23 441 абонент, 21 тариф, четыре канала коммуникации, до 20 пилотов и до 10 финальных кампаний. Основной пользователь — маркетинговый аналитик, планирующий кампании на следующий месяц.
Все данные, тарифы и эффекты синтетические. Результаты относятся к учебной симуляции; приложение не подключается к системам Beeline и не отправляет сообщения абонентам.
Навигация: запуск · требования ТЗ · алгоритм · интерфейс · результаты · проверки · сдача · развитие.
Проблема и решение
Смена тарифа может увеличить выручку, не изменить её или привести к downsell. Контакт тоже расходует ресурсы: более дорогой канал не обязательно окупится на выбранном сегменте. Публичная история относится к другой выборке абонентов, поэтому историческое среднее нельзя напрямую переносить на текущую аудиторию.
Tariflow использует историю для построения гипотез, а решение о кампании уточняет по результатам публичных пилотов. Аналитик получает сегмент, целевой тариф, канал, прогноз расходов, осторожную оценку эффекта и ссылки на наблюдения, объясняющие выбор. Это автоматизирует перебор и делает решение проверяемым; фактическая экономия времени аналитика отдельно не измерялась.
Основной сценарий:
- Запустить агента на текущем профиле аудитории.
- Дождаться исследования: гипотезы → пилоты → обновление оценок.
- Просмотреть выбранные кампании, ресурсы и причины исключения альтернатив.
- Проверить результат официальным evaluator и сформировать
submission.csv.
Соответствие ТЗ
| Обязательное требование | Реализация | Как проверить |
|---|---|---|
agent.py, класс Agent, метод act(env) | Агент возвращает list[dict] через официальный интерфейс | python local_eval.py завершается со статусом PASS |
| От 1 до 10 корректных кампаний | Допустимые фильтры, тарифы, каналы и размеры аудиторий | Нет отброшенных кампаний; контрольный seed 42 даёт 3 финальные кампании |
| Пилоты влияют на решение | env.run_pilot обновляет оценки следующих проверок и итогового плана | Контрольный запуск проводит 20 пилотов; логика — в Agent.act |
| Ресурсные лимиты соблюдены | Учитываются пилотные и финальные расходы, контакты и пересечения | Контроль: 46 598 / 100 000 у.е., 5 606 / 15 000 контактов |
| Воспроизводимый официальный CSV | Файл создаёт исходный make_submission.py | python make_submission.py; проверка совпадения модульного и standalone запуска |
Все ограничения действуют одновременно:
| Ограничение | Значение |
|---|---|
| Общий бюджет, включая пилоты | 100 000 у.е. |
| Все контакты, включая пилотные и повторные | 15 000 |
| Финальные кампании | 1–10 |
| Аудитория одной финальной кампании | Не более 5 000 |
| Число пилотов | Не более 20 |
| Размер одного пилота | 10–200 абонентов |
| Время работы по ТЗ, включая обращения к модели | Не более 10 минут |
Метрика кейса:
Чистый результат = прирост ARPU по уникальным абонентам
                   − стоимость всех контактов, включая пилоты
Эффект пропорционален predicted_arpu конкретного абонента. При повторных контактах учитывается лучший эффект для абонента, но расходы повторных контактов сохраняются. Базовая выручка 150 641 084 у.е. не является приростом.
| Канал | Стоимость контакта | Публичный множитель эффекта в кейсе |
|---|---|---|
push | 0 у.е. | ×0,50 |
sms | 4 у.е. | ×0,65 |
digital_ads | 22 у.е. | ×0,85 |
call | 160 у.е. | ×1,20 |
Источники требований: guide участника, ТЗ с критериями оценки. Границы проекта — PROJECT.
Запуск из чистого checkout
Требования к окружению
| Инструмент | Для чего нужен |
|---|---|
| Python 3.12 | Агент, официальный evaluator, локальный сервер и упаковка |
pandas==3.0.1, numpy==2.3.5 | Обработка данных; версии закреплены в requirements.txt |
| Git | Клонирование, версия в manifest и сравнение ревизий |
PowerShell 7 (pwsh) и ripgrep (rg) | Полный скрипт scripts/verify.ps1, включая проверку секретов |
| Node.js | Только веб-тесты; проверено на 24.19.0, npm-зависимостей нет |
| Браузер | Необязательный локальный интерфейс |
Официальный автономный запуск не требует Node.js, PowerShell 7, браузера или ключа OpenAI. Интернет нужен для клонирования и установки зависимостей; после установки offline-расчёт работает без сети. Проверенное окружение: Python 3.12.14, pandas 3.0.1, NumPy 2.3.5.
Получите проект и перейдите в его корень:
git clone https://github.com/BAITC-Hacks/hack-25081c1e-1718.git
cd hack-25081c1e-1718
Windows — PowerShell
Убедитесь, что python --version показывает Python 3.12. Если установлено несколько версий, для создания окружения можно использовать py -3.12 -m venv .venv вместо второй команды.
python --version
python -m venv .venv
.\.venv\Scripts\python.exe -m pip install -r requirements.txt
$env:ARPU_PYTHON = (Resolve-Path .\.venv\Scripts\python.exe).Path
$env:ARPU_OFFLINE = '1'

& $env:ARPU_PYTHON -X utf8 local_eval.py
& $env:ARPU_PYTHON -X utf8 local_eval.py --runs 10
& $env:ARPU_PYTHON -X utf8 make_submission.py
Linux / macOS — bash или zsh
python3.12 --version
python3.12 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt
export ARPU_PYTHON="$PWD/.venv/bin/python"
export ARPU_OFFLINE=1

"$ARPU_PYTHON" -X utf8 local_eval.py
"$ARPU_PYTHON" -X utf8 local_eval.py --runs 10
"$ARPU_PYTHON" -X utf8 make_submission.py
В следующих примерах используется созданное окружение: Windows — & $env:ARPU_PYTHON, Linux/macOS — "$ARPU_PYTHON". Активация .venv не требуется. Переменные нужно задать снова при открытии нового терминала. -X utf8 предотвращает ошибки кодировки русского вывода в Windows.
Что должно получиться
Одиночный local_eval.py использует seed 42, --runs 10 — seed 0–9. Для контрольного автономного запуска ожидаются:
| Показатель | Результат |
|---|---|
| Статус evaluator | PASS |
| Чистый результат | 685 149,52 у.е. |
| Финальные кампании / пилоты | 3 / 20 |
| Расход с пилотами | 46 598 у.е. |
| Контакты с пилотами | 5 606 |
| Уникальные абоненты | 2 903 |
Официальный вывод округляет net до 685150. Его строка Кампаний: 23 включает 20 пилотов и 3 финальные кампании и не означает превышения лимита финального плана.
После make_submission.py в корне появляется submission.csv с тремя строками кампаний и семью колонками:
campaign_name,filter_arpu_segment,filter_data_segment,filter_call_segment,filter_current_tariff,target_tariff,channel
В выходе Agent.act обязательны target_tariff и channel; пропущенный фильтр означает отсутствие ограничения. Несколько текущих тарифов в filter_current_tariff разделяются ;. Имена кампаний служат стабильными техническими идентификаторами.
Как работает агент
Tariflow реализует один управляющий Agent с инструментом env.run_pilot, состоянием наблюдений и циклом пересмотра решений. Модули кандидатов, оценивания и советника работают внутри этого цикла.
flowchart LR
    Data[Публичные данные] --> Candidates[Гипотезы]
    Candidates --> Agent[Agent.act]
    Agent -->|Проверка| Pilot[env.run_pilot]
    Pilot -->|Наблюдения и ресурсы| Agent
    Advisor[Необязательный LLM-советник] --> Agent
    Agent --> Plan[Допустимый план]
    Plan --> Eval[Официальная оценка и CSV]
    Eval --> Report[Отчёт и интерфейс]
- Построение гипотез.
candidate_model.pyиспользует сегменты по ARPU, данным, звонкам и текущему тарифу. Кандидаты опираются на поля каталога, а не порядок номеровtariff_N. Фильтр должен точно описывать аудиторию: большую группу нельзя просто обрезать и вернуть прежний фильтр. - Осторожный перенос истории. История переходов принадлежит другой выборке. Её ID не соединяются с ID целевой базы. Дубликаты и некорректные знаменатели исключаются; исторические отношения ограничиваются и сглаживаются. В ядре вклад истории ограничен пятью псевдонаблюдениями, поэтому наблюдения пилотов имеют приоритет.
- Разведка и обновление. Агент проводит пилоты через публичный API, перечитывает фактический размер, эффект и остатки ресурсов. Следующие проверки зависят от полученных результатов. Обычный режим использует первые пилоты до 150 и повторные до 200 клиентов; размеры по этапам фиксированы.
- Подтверждение и канал. Для обычного включения в план нужны два завершённых пилота выбранного кандидата именно на его канале. Публичные множители помогают выбрать, что проверить, но наблюдения SMS не выдаются за измерение эффекта рекламы. Для подтверждённых гипотез агент может проверить более дорогой канал с резервом на пилоты и финальную кампанию.
- Неопределённость и ресурсы. Из оценки эффекта вычитаются коммуникационные расходы и эвристический запас неопределённости. Размер выборки влияет на этот запас. Это осторожная эвристика, а не калиброванный доверительный интервал.
- Выбор набора. Для небольшого пула допустимых вариантов используется ограниченный перебор совместимых наборов; для большего — жадный выбор. Учитываются бюджет, контакты, пересечение аудиторий и максимум 10 кампаний. Если положительного допустимого набора нет, возвращается обязательная резервная кампания с предупреждением; прибыль такого fallback не гарантируется.
Основной режим — baseline/template/fixed. Экспериментальные политики balanced, confirmation_first, эмпирическая неопределённость и адаптивный размер пилота реализованы отдельно и не включены по умолчанию: сравнительные испытания не подтвердили их преимущество.
Для разведочного цикла предусмотрен порог времени 220 секунд; локальный веб-сервер ограничивает дочерний расчёт 300 секундами. Это отдельные предохранители, а не доказательство соблюдения глобального лимита на любом оборудовании. Полный запуск следует проверять в целевом окружении.
Подробности: ARCHITECTURE, анализ публичных данных, схема отчёта.
Данные и технологии
| Файл | Роль |
|---|---|
customer_profile.csv | Целевая база, сегменты, текущий тариф, потребление и predicted_arpu |
tariff_dictionary.csv, feature_dictionary.csv | Каталог тарифов и описание признаков |
data/change_tariff.csv | Публичная история переходов для слабых исторических приоров |
data/traffic.csv, data/arpu_monthly.csv, data/dict_tariff.csv | Дополнительная история и справочники для аудита данных |
Генератор кандидатов во время расчёта читает историю переходов и переданные публичные таблицы профиля/тарифов. Остальные исторические файлы не объявляются дополнительными обучающими признаками модели. Аудит описывает сдвиг выборки, пропуски, дубликаты и ограничения переноса истории.
Стек: Python 3.12 + pandas + NumPy, стандартная библиотека для HTTP, JSON и упаковки; HTML/CSS/JavaScript modules для интерфейса. Базы данных, сборщика frontend и обязательного облачного сервиса нет. В разработке использован Codex.
Необязательный OpenAI-режим
Агент может обратиться к OpenAI Responses API до двух раз: перед первыми пилотами и после обратной связи. Советник получает ограниченный набор уже созданных гипотез и наблюдений и предлагает приоритеты существующих candidate_id. Он не меняет фильтры, каналы, бюджет или правила допустимости. Ответ проверяется по схеме и допустимым идентификаторам.
Один запрос советника ограничен таймаутом 15 секунд и 900 выходными токенами. Отсутствие ключа, ошибка сети, таймаут или невалидный ответ переводят расчёт на автономную логику. Воспроизводимые показатели в этом README получены в offline-режиме.
| Переменная | Назначение |
|---|---|
ARPU_OFFLINE=1 | Принудительно отключить сетевые советы |
OPENAI_API_KEY | Ключ только из окружения процесса |
OPENAI_MODEL | Необязательная модель; значение по умолчанию указано в .env.example |
ARPU_PYTHON | Интерпретатор для PowerShell-проверок; к стратегии отношения не имеет |
Для локального демо ключ можно ввести скрыто в терминале:
& $env:ARPU_PYTHON -X utf8 server.py --ask-key
Linux/macOS: "$ARPU_PYTHON" -X utf8 server.py --ask-key. Опция действует на текущий процесс и отключает в нём ранее заданный offline-режим. Для прямого local_eval.py с ключом в окружении необходимо снять ARPU_OFFLINE: Remove-Item Env:ARPU_OFFLINE -ErrorAction SilentlyContinue в PowerShell или unset ARPU_OFFLINE в bash/zsh. Файлы .env автоматически не загружаются; .env.example содержит только пример имён настроек.
Ключ не передаётся браузеру и не сохраняется приложением. Вызовы внешнего API могут тарифицироваться. Наличие ключа не означает, что совет был получен и принят: фактический режим отражается в отчёте.
Веб-интерфейс и демо
Запуск приложения
После подготовки Python-окружения:
& $env:ARPU_PYTHON -X utf8 server.py --offline
Linux/macOS: "$ARPU_PYTHON" -X utf8 server.py --offline.
Откройте http://127.0.0.1:8765, выберите автономный режим, оставьте seed 42 и нажмите «Запустить анализ». Дождитесь завершения. Остановка сервера — Ctrl+C. Сразу после старта отчёта ещё нет; «Открыть последний расчёт» работает после первого успешного прогона.
Интерфейс поддерживает русский и казахский языки и показывает:
- измеренный итог симуляции, использованные ресурсы и плановые остатки;
- исследованные гипотезы, варианты с каналами, повторные пилоты и причины исключения;
- карточки кампаний с оценкой, неопределённостью и ссылками на собственные пилоты;
- таблицы наблюдений и объяснения по текущему серверному снимку;
- реальные состояния загрузки, ошибки, пустого и сохранённого отчёта.
Прогноз и измеренный итог имеют разный состав: forecast_summary оценивает только финальные кампании, а evaluation включает пилоты и финальные кампании с дедупликацией. Их разность нельзя интерпретировать как ошибку прогноза. Сумма размеров пилотов — число контактов, а не обязательно уникальных людей.
Ответы по отчёту не запускают кампании и не меняют план. Числовая сводка формируется из фактов снимка; необязательная модель добавляет качественное пояснение. Каждый вопрос обрабатывается отдельно, без памяти предыдущего диалога. Автономный ответ и ответ модели явно различаются; неподдерживаемые ссылки и известные ошибки ответа вызывают fallback. Контракт — API.
Реальные скриншоты интерфейса
Обзор на русском, 1440 px, синтетический автономный запуск:
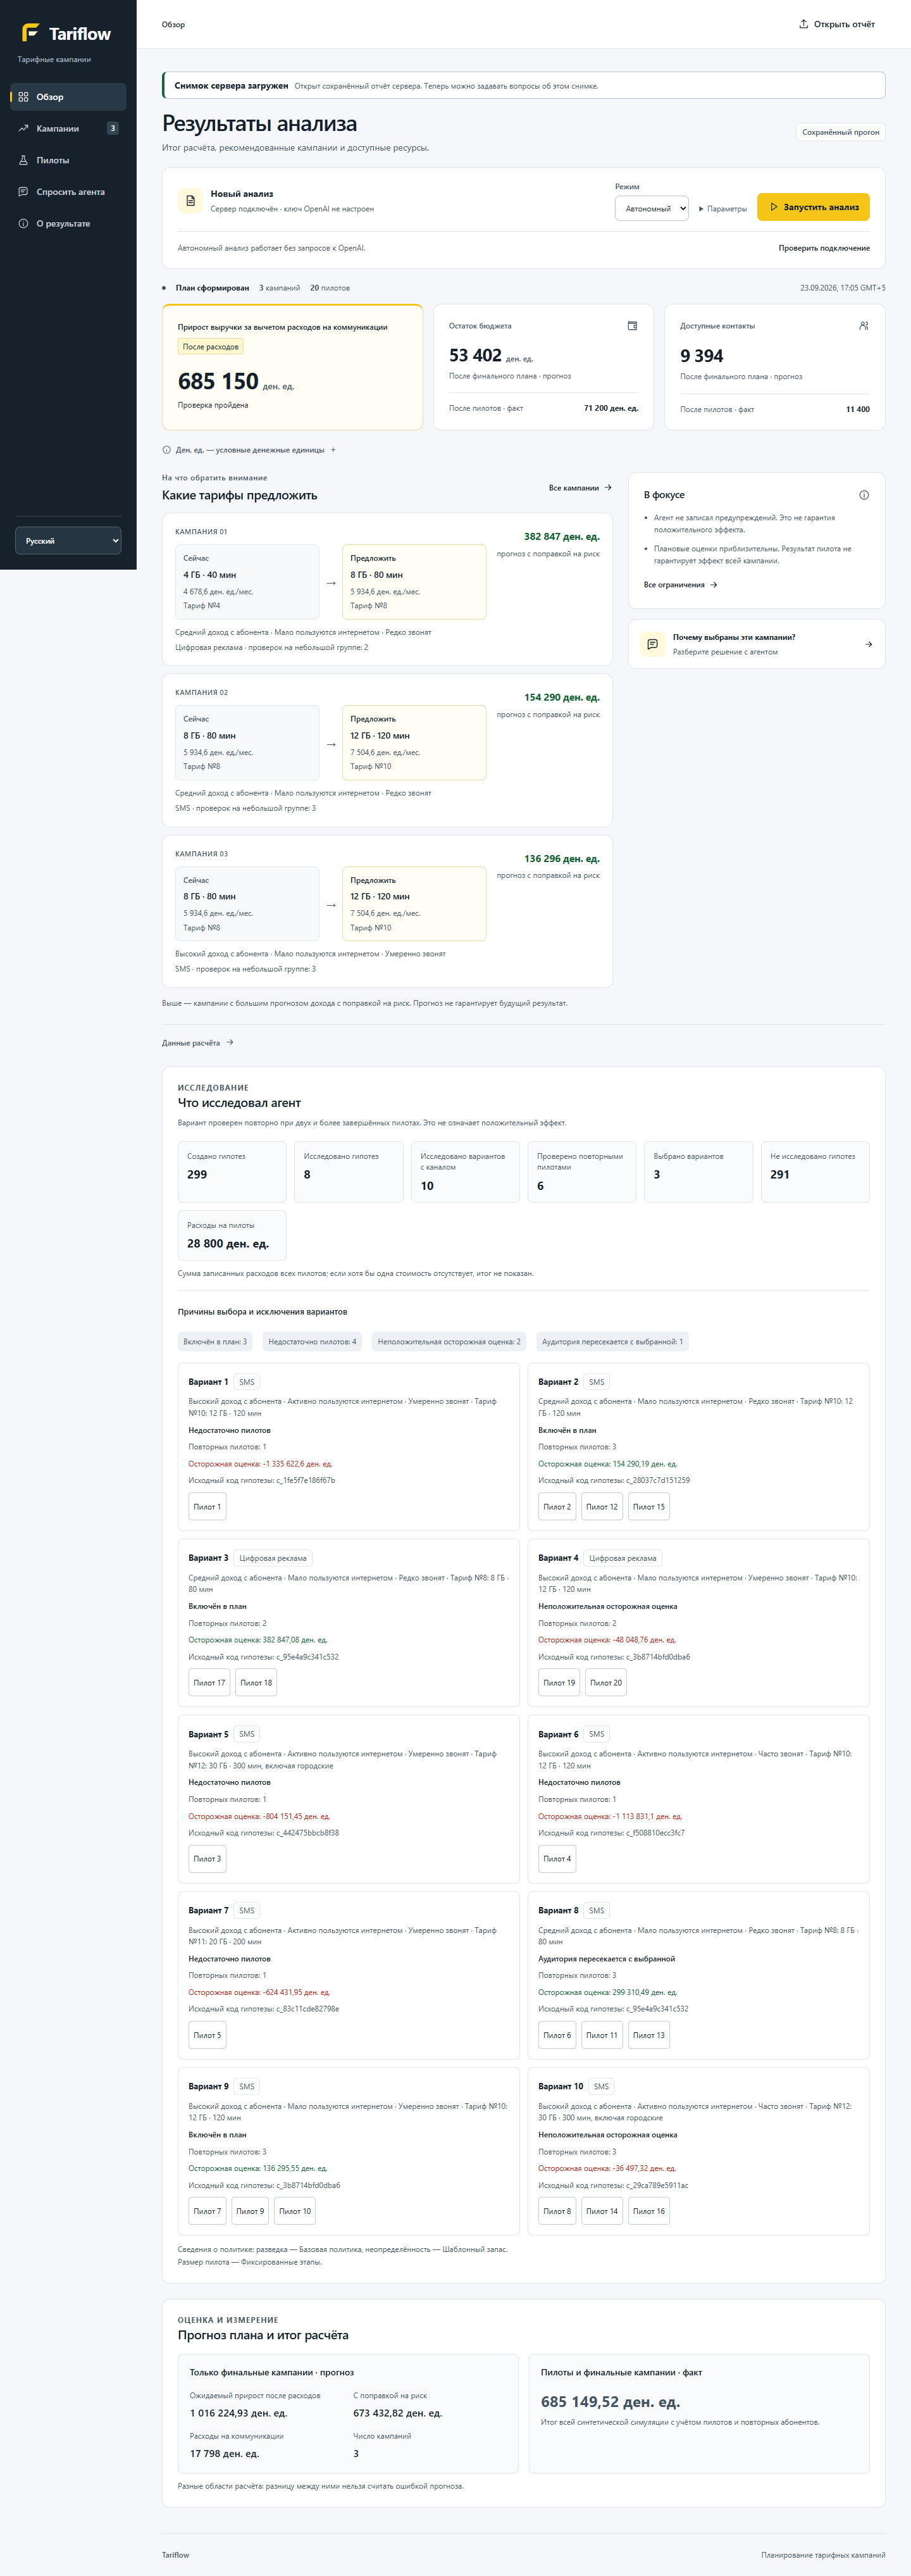
Казахский интерфейс, 1440 px · мобильный, 375 px · планшет, 768 px. В web/screenshots/ сохранены все шесть снимков RU/KK. Изображения доступны в полном репозитории и не входят в небольшой архив агента; для просмотра закрытого репозитория нужен доступ GitHub.
Просмотр сохранённого отчёта без API
& $env:ARPU_PYTHON -X utf8 scripts/run_agent.py --offline
& $env:ARPU_PYTHON -m http.server 8080 --bind 127.0.0.1 --directory web
Linux/macOS: выполните те же команды с "$ARPU_PYTHON" вместо & $env:ARPU_PYTHON. Откройте http://127.0.0.1:8080 и импортируйте output/report.json. Импорт остаётся в браузере. Запуск расчёта и вопросы требуют локального API на 8765 и его собственного снимка; произвольный импорт не становится серверным отчётом.
Демо за две минуты: запуск → итог и ресурсы → исследованные гипотезы → выбранная кампания и её пилоты → объяснение → официальный CSV. Подробный сценарий и проверка состояний — DEMO.
Подтверждённые результаты
Все суммы ниже — чистый результат синтетической симуляции, а не оценка реальной выручки оператора. Серии имеют разные seed и назначение; их нельзя объединять в один показатель «точности».
| Проверка | Объём | Результат | Доказательства |
|---|---|---|---|
| Контроль и standalone-поставка | Seed 42 | Net 685 149,52; модульный и самостоятельный агент совпадают точно, CSV — побайтно | Release-протокол |
| Официальная устойчивость | Seed 0–9 | 10/10 положительных; медиана 615 745, минимум 418 038 (округлено) | Официальный журнал |
| Разработческое сравнение | Seed 200–209, 7 режимов, 70 запусков | Все запуски технически валидны; ни один экспериментальный режим не прошёл условия замены основного | Исходные результаты |
| Независимая проверка | Seed 300–319, 2 режима, 40 запусков | Основной и адаптивный режимы: 20/20 положительных каждый; преимущество адаптивного не подтверждено | Исходные результаты |
Результаты независимой серии:
| Режим | Медиана net | 10-й процентиль net | Положительных |
|---|---|---|---|
baseline/template/fixed | 674 970,62 | 529 955,35 | 20/20 |
| Адаптивный размер пилота | 642 092,75 | 494 131,63 | 20/20 |
Адаптивный вариант улучшил 8 пар и ухудшил 12; медиана парного изменения — −12 446,91. Поэтому основной режим сохранён. Вариант был зафиксирован до независимой серии; параметры по её результатам не подбирались. Неудачные варианты и отрицательные исходы сохранены в протоколах.
Полная проверка модульного/standalone соответствия зафиксирована на 9a1b3b1; отчёт содержит SHA, версии и хеши CSV. После UI-обновления 02b9288 и очистки структуры прошли 69 Python + 7 analysis + 34 Node-теста. На 4d821bf повторно прошли 69 Python-тестов и официальный evaluator; поведение алгоритма при изменении названия не менялось. Документирование и упаковка не подменяют числовые свидетельства исходных прогонов.
Для OpenAI есть отдельная малая проверка: три offline/online пары на seed 120–122, шесть обращений советника. Она подтверждает работу пути интеграции, но не устойчивое экономическое преимущество модели. Протокол. Общая сводка — VALIDATION.
Проверки и воспроизводимость
Для полного набора проверок установите PowerShell 7, ripgrep и Node.js, доступные как pwsh, rg, node. В корне проекта, после задания ARPU_PYTHON:
pwsh -NoProfile -File ./scripts/verify.ps1 -Release
& $env:ARPU_PYTHON -B -X utf8 -m unittest analysis.test_candidates -q
node --test web/api.test.mjs web/report.test.mjs web/i18n.test.mjs
Linux/macOS:
pwsh -NoProfile -File ./scripts/verify.ps1 -Release
"$ARPU_PYTHON" -B -X utf8 -m unittest analysis.test_candidates -q
node --test web/api.test.mjs web/report.test.mjs web/i18n.test.mjs
verify.ps1 -Release проверяет возможные секреты, стратегию, отчёт, локализацию, серверные ответы, изоляцию сравнений и сборку; затем выполняет официальный evaluator и заново создаёт/проверяет CSV. Анализ данных и веб-тесты запускаются отдельными командами выше. Прохождение тестов подтверждает проверенные свойства, но не доходность на неизвестных эффектах.
Экспериментальные режимы можно воспроизводить через scripts/quality_benchmark.py. Например, из чистой сохранённой Git-ревизии:
& $env:ARPU_PYTHON -X utf8 scripts/quality_benchmark.py --baseline-ref HEAD --current-ref HEAD --variants adaptive --seeds 400,401,402 --label reproduction
Это новая локальная серия, не источник опубликованных выше чисел. Скрипт запускает снимки ревизий в отдельных процессах, сохраняет хеши кода/данных, валидацию и результаты в output/quality-reproduction.json. Для оценки новых изменений нужны заранее отделённые seed; опубликованную независимую серию нельзя превращать в набор для подбора параметров.
Артефакты для сдачи
Сначала выполните официальный запуск и make_submission.py либо полный verify.ps1 -Release, затем соберите пакет:
& $env:ARPU_PYTHON -X utf8 scripts/package_submission.py
Linux/macOS: "$ARPU_PYTHON" -X utf8 scripts/package_submission.py.
| Результат | Назначение |
|---|---|
output/submission/agent.py | Самостоятельный файл агента; модули кандидатов и советника встроены |
output/submission/submission.csv | Точные байты CSV из официального генератора |
output/submission/requirements.txt | Закреплённые зависимости |
output/submission/README.md, SUBMISSION.md, связанные документы | Подход, инструкции и документы, достижимые по ссылкам из README; точный состав указан в manifest |
output/submission/manifest.json | Исходный Git SHA, признак изменённого дерева, версии, перечень файлов и SHA-256 |
output/submission.zip | Архив перечисленных файлов |
При загрузке одного agent.py берите файл из output/submission/, поскольку корневой модульный агент использует соседние собственные модули. Самостоятельный агент проверен без внешних candidate_model.py и llm_advisor.py.
ZIP предназначен для наложения на исходный комплект участника с сохранением относительных путей. Он не содержит публичные входные CSV, официальный evaluator, веб-сервер или полный интерфейс: для них используется исходный комплект либо полный репозиторий. SUBMISSION.md описывает этот режим отдельно. Сборщик не пересчитывает результат и не обновляет CSV, поэтому генерация CSV должна предшествовать упаковке.
Поле dirty=true в manifest означает, что сборка выполнена с локальными изменениями; для фиксированной поставки используйте чистую сохранённую ревизию. Готовый локальный архив не подтверждает отправку организаторам; факт отправки в репозитории не зафиксирован.
Структура проекта
| Путь | Содержимое |
|---|---|
agent.py, candidate_model.py, llm_advisor.py | Управляющий агент, гипотезы и ограниченный советник |
server.py, report_assistant.py, report_localization.py | Локальный API и объяснения по отчёту на RU/KK |
local_eval.py, make_submission.py, файлы среды | Исходный инструментарий официальной проверки |
| Корневые CSV | Профиль, тарифы, описание признаков и итоговая submission |
data/ | Дополнительная публичная история |
analysis/ | Аудит данных и проверки кандидатов |
scripts/ | Запуск, экспорт, тесты, сравнения и упаковка |
web/ | Интерфейс, веб-тесты и реальные скриншоты |
docs/ | Спецификация, архитектура, API, схема отчёта, демо и протоколы |
output/ | Локальные генерируемые отчёты и архив; не отслеживается Git |
Корень сохраняет раскладку официального комплекта: агент, evaluator, генератор submission и основные CSV находятся рядом для штатных команд запуска. Перенос в src/ потребовал бы изменения путей и импортов официального сценария.
Ценность, отличия и критерии оценки
Отличия подхода: слабые исторические приоры с учётом другой выборки; реальные повторные пилоты для варианта и канала; выбор набора с ресурсами и пересечениями; раскрытие причин выбора; ограниченный LLM-советник с автономным резервным режимом. Интерфейс связывает решение с наблюдениями и отделяет прогноз плана от измеренного результата всей симуляции.
| Критерий ТЗ | Вес | Что представлено для проверки |
|---|---|---|
| Соответствие задаче и работоспособность | 25 | Agent.act, публичные пилоты, допустимый план, официальный evaluator и CSV |
| Техническая реализация | 25 | Цикл с обратной связью, неопределённость, экономика каналов, выбор набора, LLM с fallback, контракты и тесты |
| README и воспроизводимость | 25 | Окружение, команды двух ОС, ожидаемые результаты, исходные протоколы и standalone-поставка |
| Ценность и применимость | 15 | План для маркетингового аналитика с объяснениями и контролем расходования ресурсов |
| Оригинальность и развитие | 10 | Подтверждение собственными пилотами, осторожный перенос истории, независимые сравнения и план дальнейшей валидации |
Таблица показывает, где проверять каждый критерий; она не присваивает проекту баллы жюри.
Ограничения и развитие
- Синтетическая среда. Положительный net на локальных эффектах не гарантирует результат на скрытой оценке или реальную коммерческую прибыль. Размеченной задачи детекции нет, поэтому метрика accuracy здесь не заявляется.
- Ограниченная разведка. При 20 пилотах исследуется лишь часть гипотез. Основные размеры пилотов заданы этапами 150/200; экспериментальная адаптация не показала достаточного преимущества.
- Неопределённость и история. Запас эвристический, история наблюдательная; покрытия всех абонентов и причинной оценки эффекта нет. Неполные или невыразимые фильтрами сегменты могут быть исключены.
- Объяснения модели. Проверки структуры, ссылок и известных ошибок не доказывают истинность любого свободного текста. Выводы следует сверять с пилотами и полями отчёта.
- Локальный продукт. Нет CRM-интеграции, пользовательской авторизации, совместной работы или настоящей отправки сообщений. Сервер предназначен для локального демо на
127.0.0.1.
План развития: калибровать неопределённость на отдельных сценариях; оценивать новые политики пилотирования на заранее отложенных seed; проверить устойчивость к сдвигу аудитории и стоимости каналов; измерить время и качество решений аналитиков; затем валидировать перенос на разрешённых бизнес-данных с дополнительными ограничениями, контролем доступа и отдельным экспериментальным дизайном.
Если запуск не удался
| Симптом | Что проверить |
|---|---|
ModuleNotFoundError: pandas или numpy | Установите requirements.txt именно через интерпретатор созданной .venv; используйте его во всех командах |
| Ошибка версии Python | Проект проверен на 3.12; пересоздайте окружение нужным интерпретатором |
| Не найдены CSV или модули | Выполняйте команды из корня полного репозитория; маленький ZIP требует исходный комплект участника |
Не найдены pwsh, rg или node | Установите инструмент для соответствующей дополнительной проверки и откройте новый терминал; официальный Python-запуск независим от них |
| Порт 8765 занят | Остановите прежний сервер либо запустите server.py --offline --port 8766 и откройте этот порт |
| После старта нет отчёта | Выполните первый анализ; сохранённый JSON автоматически не становится серверным снимком |
| Импорт работает, а вопросы недоступны | Откройте UI сервера на 8765 и создайте отчёт через него |
| OpenAI не используется | Проверьте ARPU_OFFLINE, наличие ключа и фактический статус в отчёте; для автономной проверки ключ не нужен |
Документы: архитектура · API · схема отчёта · результаты и границы проверки · двухминутное демо.
Авторы коммитов
История коммитов
- 2026-09-23 17:39docs: document Tariflow requirements and reproducible deliveryDmitrii
- 2026-09-23 17:24fix: use Tariflow branding in launch commandsDmitrii
- 2026-09-23 17:21chore: remove development harness and consolidate delivery docsDmitrii
- 2026-09-23 17:15feat(web): explain pilot decisions and verified campaign outcomeszi-radio
- 2026-09-23 17:07docs: retain baseline after heldout trials and verify clean deliveryDmitrii
- 2026-09-23 17:02docs: freeze adaptive pilot candidate after paired development runsDmitrii
- 2026-09-23 17:01fix: make submission packaging and comparison isolation verifiableDmitrii
- 2026-09-23 16:57feat: add gated pilot sizing and confirmation experimentsDmitrii
Все коммиты (52)
- 2026-09-23 16:54docs: coordinate final campaign quality and delivery workDmitrii
- 2026-09-23 16:48fix: move language switch to sidebar footerzi-radio
- 2026-09-23 16:46docs: audit judging criteria and record verified release evidenceDmitrii
- 2026-09-23 16:46fix: route report evidence questions and align Kazakh terminologyDmitrii
- 2026-09-23 16:43fix: align Kazakh hypothesis and result wordingzi-radio
- 2026-09-23 16:38feat: add Russian and Kazakh Tariflow interfacezi-radio
- 2026-09-23 16:32feat: support grounded Russian and Kazakh report answersDmitrii
- 2026-09-23 16:21fix: constrain model commentary to verified report sourcesDmitrii
- 2026-09-23 16:21docs: coordinate Kazakh interface and agent responseszi-radio
- 2026-09-23 16:17docs: retain baseline after frozen quality holdoutDmitrii
- 2026-09-23 16:16fix: remove chat keyboard hintzi-radio
- 2026-09-23 16:13fix: support legacy report evidence and freeze quality candidateDmitrii
- 2026-09-23 16:12fix: remove redundant workspace labelszi-radio
- 2026-09-23 16:10feat: add isolated quality experiments and grounded report diagnosticsDmitrii
- 2026-09-23 16:01feat: add Tariflow faviconzi-radio
- 2026-09-23 15:58docs: define quality experiments and report diagnostics contractDmitrii
- 2026-09-23 15:57docs: record published Tariflow integration and handoffzi-radio
- 2026-09-23 15:54feat: introduce Tariflow identity and dashboard shortcutszi-radio
- 2026-09-23 15:46docs: record verified campaign answers and UI integrationDmitrii
- 2026-09-23 15:43fix: compact missing campaign ranges in answersDmitrii
- 2026-09-23 15:42fix: ground campaign answers in matching pilot evidenceDmitrii
- 2026-09-23 15:36feat: explain tariff offers and monetary unitszi-radio
- 2026-09-23 15:27feat: refine Compass identity and report conversationzi-radio
- 2026-09-23 15:18feat: optimize and validate confirmed campaign portfoliosDmitrii
- 2026-09-23 15:11feat: finish marketer workflow and demozi-radio
- 2026-09-23 15:07fix: align API timestamps with the web adapterDmitrii
- 2026-09-23 15:04feat: serve analysis runs and grounded OpenAI answersDmitrii
- 2026-09-23 15:03feat: connect analysis and report questions to local APIzi-radio
- 2026-09-23 15:01feat: reshape marketer workspace and recommendationszi-radio
- 2026-09-23 14:50docs: split product upgrade and freeze the web API contractDmitrii
- 2026-09-23 14:40feat: package the full agent for standalone submissionDmitrii
- 2026-09-23 14:38docs: record completed web and current integrationzi-radio
- 2026-09-23 14:35feat: add accessible campaign report viewerzi-radio
- 2026-09-23 14:33feat: select stronger scouting within a fixed budgetDmitrii
- 2026-09-23 14:27fix: atomically export validated campaign reportsDmitrii
- 2026-09-23 14:23feat: confirm paid channels with bounded pilot pairsDmitrii
- 2026-09-23 14:16docs: confirm candidate integration and web handoffzi-radio
- 2026-09-23 14:13chore: strengthen release checks and four-minute team handoffsDmitrii
- 2026-09-23 14:09fix: reduce communication costs during pilot explorationDmitrii
- 2026-09-23 14:08feat: add cautious public-data candidateszi-radio
- 2026-09-23 14:01fix: restrict campaign estimates to measured channelsDmitrii
- 2026-09-23 13:50feat: integrate adaptive pilot planning and OpenAI advisorDmitrii
- 2026-09-23 13:30feat: initialize ARPU Compass challenge workspaceDmitrii
- 2026-09-21 22:05chore: add shared hackathon agent harnessDmitrii
Структура репозитория (71 файлов)
.env.example
.gitignore
PARTICIPANT_GUIDE.md
PARTICIPANT_GUIDE.pdf
README.md
agent.py
agent_template.py
analysis/README.md
analysis/audit_public_data.py
analysis/test_candidates.py
candidate_model.py
customer_profile.csv
data/arpu_monthly.csv
data/change_tariff.csv
data/dict_tariff.csv
data/traffic.csv
docs/API.md
docs/ARCHITECTURE.md
docs/CHALLENGE_ORIGINAL.txt
docs/DEMO.md
docs/DESIGN.md
docs/PROJECT.md
docs/REPORT_SCHEMA.md
docs/VALIDATION.md
docs/quality/followup-default-regression.json
docs/quality/followup-development.json
docs/quality/followup-holdout.json
docs/quality/followup-release.json
docs/quality/official-runs-10.txt
docs/quality/online.json
environment.py
feature_dictionary.csv
llm_advisor.py
local_eval.py
make_submission.py
mock_environment.py
report_assistant.py
report_localization.py
requirements.txt
scoring_core.py
scripts/benchmark.py
scripts/export_report.py
scripts/package_submission.py
scripts/quality_benchmark.py
scripts/run_agent.py
scripts/test_chat_language.py
scripts/test_package_submission.py
scripts/test_quality_benchmark.py
scripts/test_quality_policy.py
scripts/test_report_localization.py
scripts/test_report_quality.py
scripts/verify.ps1
server.py
submission.csv
tariff_dictionary.csv
web/api.mjs
web/api.test.mjs
web/app.mjs
web/i18n.mjs
web/i18n.test.mjs
web/index.html
web/integration.mjs
web/report.mjs
web/report.test.mjs
web/screenshots/overview-kk-1440.png
web/screenshots/overview-kk-375.png
web/screenshots/overview-kk-768.png
web/screenshots/overview-ru-1440.png
web/screenshots/overview-ru-375.png
web/screenshots/overview-ru-768.png
web/styles.css
Обсуждение 0 комментариев
Войдите, чтобы комментироватьПока нет комментариев — будьте первым.