О проекте
Команда: Shakarim
Кейс HackAlem.ai: Финансы — Freedom
Стадия: Рабочий MVP
Задача кейса: «Граф денег»: восстановить структуру организованной группы по сети транзакций (AML)
Суть
Объяснимая аналитика графа денежных переводов: метрики узлов, шесть ролей по правилам, кластеры Louvain, приоритет ручной проверки и три CSV-отчёта. Streamlit-интерфейс для поиска и исследования клиентов.
Как устроено
loader проверяет схемы трёх parquet-файлов и сверяет агрегаты. NetworkX строит направленный граф и считает суммы, степени, уникальных контрагентов, PageRank и betweenness. roles.py применяет упорядоченные правила до первого совпадения, с отдельными условиями для seed'ов с неполным входом и для границы глубины. Louvain работает на взвешенной неориентированной проекции. priority.py нормирует приоритет в 0–1 и пишет evidence до 200 символов. run.py запускает расчёт и Streamlit одной командой, AI-модели не используются.
Ключевые решения
- NetworkX
- PageRank
- betweenness
- Louvain
- ordered role rules
- Streamlit AppTest
Особенности
Seed'ы и узлы на границе глубины обрабатываются аккуратно: отсутствие выхода на глубине 4 даёт peripheral с пояснением, а не terminal. Полностью офлайн, без LLM. Для жюри подготовлен сценарий проверки на трёх конкретных GID.
Стек
Python · pandas · NumPy · PyArrow · NetworkX · SciPy · Streamlit · unittest
Проект создан за 5 часов на финале хакатона HackAlem.ai (23 сентября 2026, Астана). Код — BAITC-Hacks/hack-c4e364b4-shakarim.
README
README.mdTraceFlow — анализ графа денежных переводов
Прототип для кейса HackAlem AI «Граф денег». TraceFlow помогает аналитику исследовать транзакционную сеть: найти клиента, понять его предполагаемую роль, изучить движение средств и выбрать узлы для ручной проверки.
Роли, кластеры и приоритет — объяснимые гипотезы на основе наблюдаемых переводов. Они не являются доказательством нарушения или вероятностью виновности.
Что реализовано
- Проверка трёх Parquet-файлов: узлы, направленные рёбра и транзакции. Сверяются суммы и число переводов по каждой паре, сохраняются длинные GID и изолированные узлы.
- Направленный граф NetworkX и метрики каждого GID: входящие и исходящие суммы, степени, число переводов, уникальные контрагенты, PageRank и betweenness.
- Шесть ролей по документированным правилам:
consolidator,transit,distributor,terminal,coordinator,peripheral. role_scoreиpriority_scoreв диапазоне 0–1, обоснованиеevidenceс конкретными числами длиной до 200 символов.- Louvain на взвешенной неориентированной проекции; исходные направления сохраняются в метриках и связях интерфейса.
- Три аналитических CSV фиксированной схемы, включая очередь из 20–100 узлов.
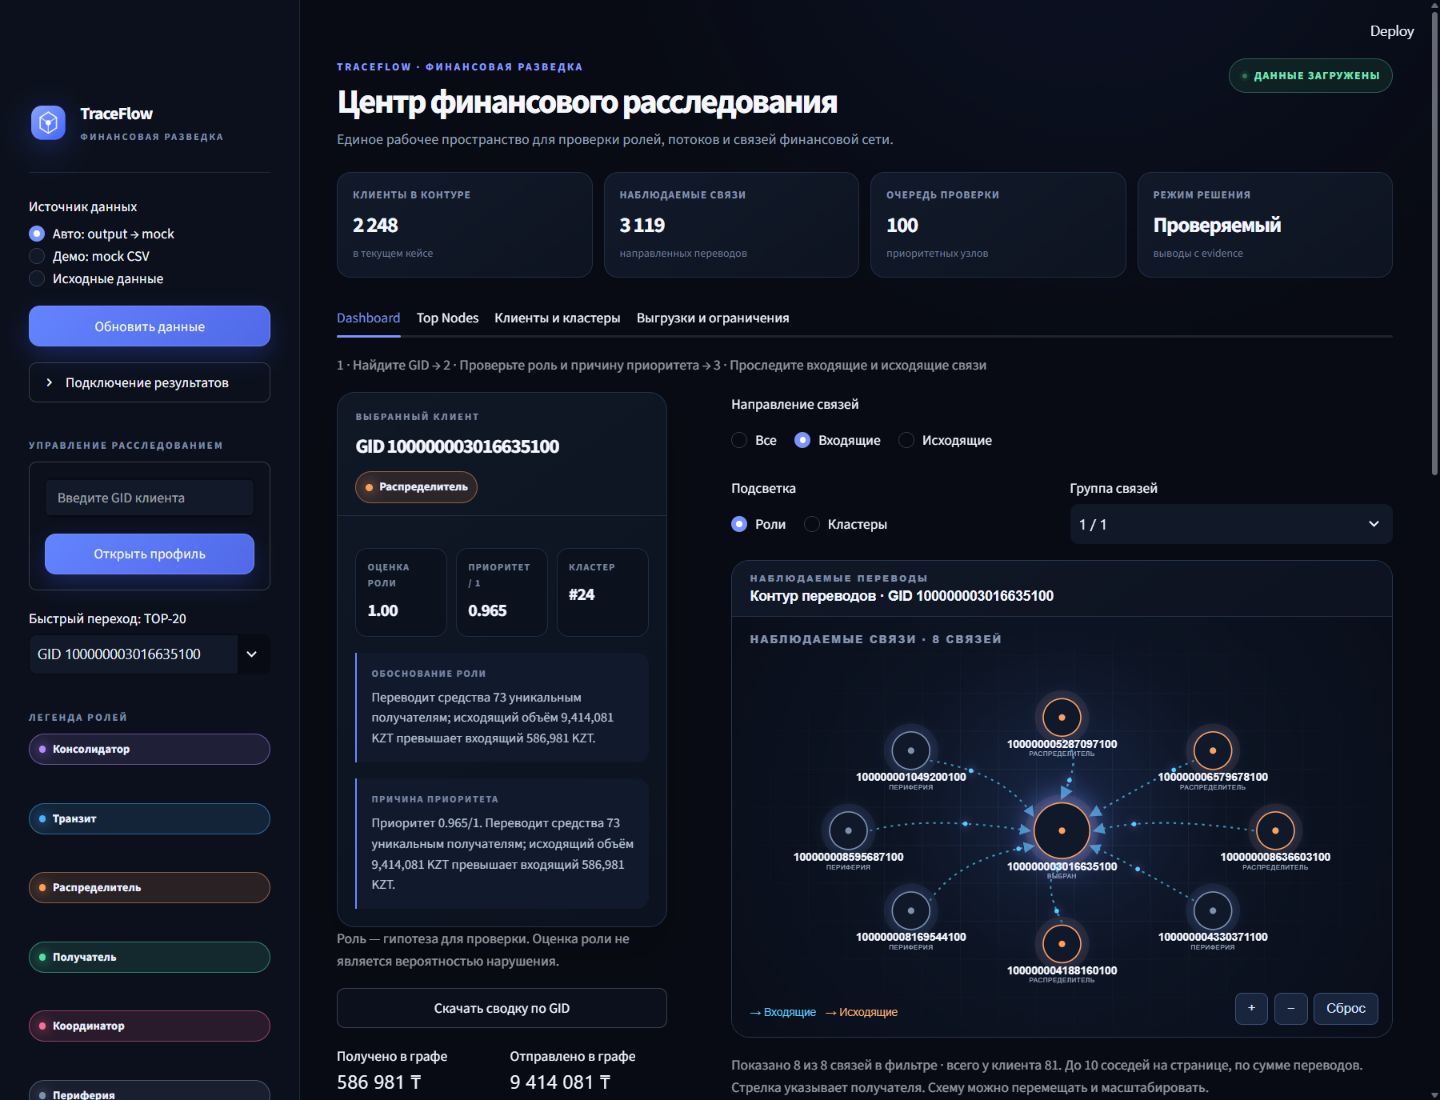
- Streamlit: поиск GID, карточка клиента, направленные связи, переход к контрагенту и возврат, TOP-20, каталог клиентов и кластеров, дневная история, скачивание отчётов и сводки по GID.
- Явно обозначенный синтетический mock-режим для демонстрации интерфейса.
- Общий запуск через
run.pyи автоматические проверки данных, аналитики, интеграции и UI.
Как работает решение
- Пользователь запускает
run.pyс исходными файлами вdata/. - Pipeline проверяет данные, строит направленный граф и сохраняет метрики каждого GID.
- Аналитика применяет правила ролей и приоритета, выделяет сообщества и сохраняет CSV в
output/. - Открывается Streamlit. Аналитик выбирает клиента из TOP-20 или ищет GID, читает объяснение, изучает связи и кластер.
- Для дальнейшей проверки можно скачать результаты и Markdown-сводку выбранного клиента.
Повторный аналитический расчёт может использовать готовый node_metrics.csv: исходный граф и метрики в этом режиме не пересчитываются.
Правила ролей и пороги
Правила из src/roles.py применяются по порядку до первого совпадения. Каждый узел получает ровно одну роль. Обозначения: I и O — входящая и исходящая суммы KZT; S и R — числа уникальных отправителей и получателей; Ni и No — числа входящих и исходящих транзакций; B = min(I,O) / max(I,O) (0 при нулевом обороте). Сумма S + R складывает два направленных счётчика: один контрагент может учитываться в обоих.
| Порядок | Роль | Условие для обычного узла | Условие для seed с неполным входом |
|---|---|---|---|
| 0 | peripheral — граница наблюдения | truncated_by_depth=true или depth >= 4 одновременно с O = R = No = out_degree = 0 | То же условие; имеет приоритет над всеми следующими правилами |
| 1 | peripheral — малая активность | I + O = 0 или одновременно S + R <= 2 и Ni + No <= 2 | То же условие |
| 2 | terminal — возможное удержание | I > 0 и O <= 0.20 × I | Не назначается |
| 3 | coordinator — признаки координации | S >= 5, R >= 5 и B >= 0.50 | S >= 5 и R >= 5; денежный баланс не используется |
| 4 | consolidator — признаки консолидации | S >= 3, I > 0 и I > 1.20 × O | I > 0, S >= 3 и S >= 2 × max(R,1) |
| 5 | distributor — признаки распределения | R >= 3, O > 0 и O > 1.20 × I | O > 0, R >= 3 и R >= 2 × max(S,1) |
| 6 | transit — признаки транзита | I > 0, O > 0 и 0.75 <= O/I <= 1.25 | Не назначается |
| 7 | peripheral — роль не определена | Ни одно предыдущее условие не выполнено | То же условие |
У seed входящий поток неполон, поэтому для него используются структурные правила без отношения денежных потоков. На границе глубины отсутствие выхода не подтверждает удержание средств: назначается peripheral с role_score=0.20 и пояснением. role_score отражает силу эвристических признаков выбранной роли, priority_score — приоритет ручной проверки; обе оценки находятся в диапазоне 0–1 и не являются вероятностями. Полные формулы и правила округления приведены в analytics.md.
Технологии
| Назначение | Технология |
|---|---|
| Язык и целевая версия | Python 3.12.10 |
| Таблицы и Parquet | pandas, NumPy, PyArrow |
| Направленный граф, метрики, Louvain | NetworkX; SciPy для численных вычислений |
| Интерфейс | Streamlit, HTML/CSS и SVG связей |
| Проверки | unittest, Streamlit AppTest |
| AI-модели, API и внешние сервисы | Не подключены; анализ выполняется локальными алгоритмами |
Зависимости приложения перечислены в requirements.txt. Для запуска не нужны API-ключи или облачный аккаунт.
Архитектура
flowchart TD
    A["data/: nodes, edges, transactions.parquet"] --> B["loader: проверка схем и агрегатов"]
    B --> C["graph_builder + metrics: направленный граф"]
    C --> D["node_metrics.csv"]
    B --> E["edges.csv: направленные связи"]
    D --> F["roles + priority"]
    D --> G["clustering: Louvain"]
    E --> G
    F --> H["export: три аналитических CSV"]
    G --> H
    H --> I["Streamlit: исследование GID"]
    D --> I
    E --> I
    A -. "история переводов" .-> I
    R["run.py"] -. "управляет запуском" .-> C
    R -. "запускает" .-> I
| Компонент | Ответственность |
|---|---|
run.py | Полный расчёт и запуск интерфейса одной командой |
src/loader.py | Чтение и проверка Parquet |
src/graph_builder.py, src/metrics.py | Направленный граф, метрики всех узлов |
src/roles.py, src/priority.py | Правила, оценки и объяснения |
src/clustering.py | Взвешенная проекция и сообщества Louvain |
src/export.py, src/pipeline.py | Проверка результатов, CSV и последовательность расчёта |
ui/ | Чтение аналитики, поиск, карточки, граф, таблицы и скачивание |
data/, mock/ | Предоставленная выгрузка и отдельный синтетический пример |
tests/ | Проверки модулей, полного расчёта и UI |
UI не определяет роли и не пересчитывает аналитические оценки. Подробные правила — в analytics.md, контракт между компонентами — в docs/integration.md.
Установка и запуск
Нужен Python 3.12.10; целевая версия указана в .python-version. Установите её перед созданием окружения. Команды выполняются из корня репозитория.
Получить код
git clone https://github.com/BAITC-Hacks/hack-c4e364b4-shakarim.git
cd hack-c4e364b4-shakarim
git switch main
Инструкция относится к интегрированной версии в ветке main.
macOS / Linux
python3.12 --version
python3.12 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt
.venv/bin/python run.py
Windows PowerShell
py -3.12 --version
py -3.12 -m venv .venv
.\.venv\Scripts\python.exe -m pip install -r requirements.txt
.\.venv\Scripts\python.exe run.py
Активация окружения не требуется: команды используют его интерпретатор напрямую. Проверка версии должна показать 3.12.10; обозначение 3.12 в команде само по себе не устанавливает нужную patch-версию.
После установки весь проект запускается одной командой python run.py с Python из окружения. По умолчанию она читает data/, создаёт пять CSV и analysis_context.json в output/, затем открывает Streamlit на http://localhost:8501. Остановка — Ctrl+C.
Дополнительные режимы (далее python означает интерпретатор созданного окружения):
# Только расчёт и CSV
python run.py --analysis-only

# Готовые результаты; при их отсутствии UI показывает маркированный mock
python run.py --ui-only

# Другие папки и порт, без автоматического открытия браузера
python run.py --data data --output-dir output --port 8502 --headless

# Только аналитический этап по готовым метрикам и связям
python src/pipeline.py --input output/node_metrics.csv --edges output/edges.csv --output-dir output

# Отдельный полный pipeline без интерфейса
python src/pipeline.py --data data --output-dir output
После нового клонирования --ui-only показывает роли, кластеры и TOP из сохранённых в Git отчётов. Для связей, метаданных seed/depth и дневной истории сначала выполните полный python run.py (либо python run.py --analysis-only, затем --ui-only): он создаёт локальные node_metrics.csv, edges.csv и проверяемый контекст запуска.
Относительные пути аргументов разрешаются от корня проекта. run.py передаёт каталоги интерфейсу. При отдельном запуске python -m streamlit run ui/app.py можно задать переменные окружения TRACEFLOW_DATA_DIR и TRACEFLOW_RESULTS_DIR.
Режим --input сохраняет входные метрики и рёбра с каноническими именами колонок вместе с отчётами и контекстом запуска. Без --edges связи нельзя восстановить из агрегированных метрик: узлы получают отдельные кластеры, а edges.csv содержит только заголовок, заменяя старые связи. Для сетевых сообществ передайте рёбра того же набора данных. Подробности — в контракте интеграции.
Как проверить решение
Сценарий для жюри:
- Установите зависимости и выполните
python run.py. - В боковой панели выберите «Авто: output → mock». Источник должен быть «Готовые результаты пайплайна», а не синтетическое демо.
- Найдите GID
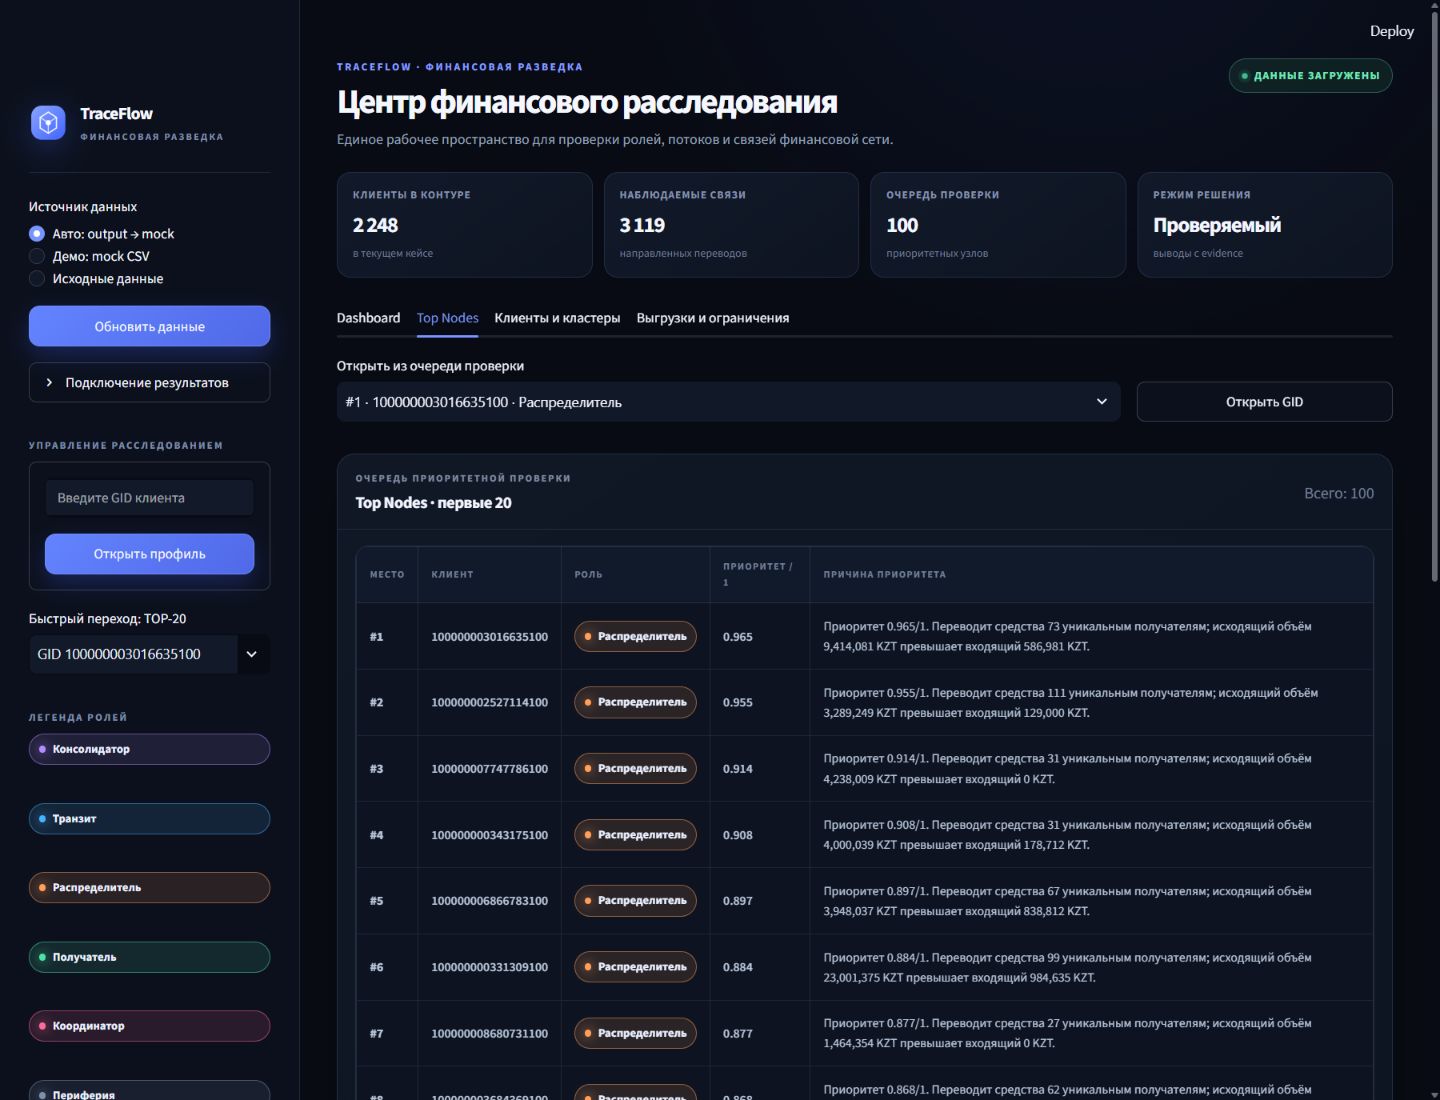
100000003016635100из приложенной выгрузки. Прочитайте роль, оценку, evidence и кластер; переключите входящие/исходящие связи. - Откройте Top Nodes, перейдите к клиенту, затем к связанному GID и вернитесь. Скачайте сводку по GID и аналитические CSV.
- Найдите
100000000404740100— узел на глубине 4 без исходящих связей; карточка должна объяснять границу наблюдения. Найдите100000000456947100— изолированный узел, который не должен исчезать из результатов. - При желании переключитесь на «Демо: mock CSV» и найдите
901245. Значения в этом режиме синтетические.
Предоставленная выгрузка содержит 2 248 узлов, 3 119 направленных рёбер, 4 840 транзакций и 81 seed. Полный запуск сохраняет все GID, включая 19 изолированных seed-узлов. В top_nodes.csv для этого набора формируется 100 строк; UI показывает первые 20 и позволяет переходить к остальным.
Автоматическая проверка:
python -m pip install -r requirements-test.txt
python -m unittest discover -s tests -v
Проверяются схемы, точность длинных GID, согласованность рёбер и транзакций, роли и ограничения наблюдения, диапазоны оценок, длина evidence, кластеризация, экспорт и UI. Интеграционные тесты используют временные каталоги. Число тестов и время запуска зависят от версии кода и окружения; актуальный результат выводит команда.
Подробный сценарий показа: docs/demo.md.
Данные и интеграции
Источник — локальная выгрузка внутрибанковских переводов за июль 2026 года: обход по исходящим переводам от 81 seed, глубина до четырёх колен, порог от 5 000 KZT. Это параметры предоставленного набора, а не универсальные ограничения загрузчика. Описание датасета.
| Входной файл | Обязательные колонки |
|---|---|
data/nodes.parquet | gid, depth, is_seed |
data/edges.parquet | src, dst, sum_kzt, n_tx, depth |
data/transactions.parquet | src, dst, date, sum_kzt |
Полный расчёт создаёт node_metrics.csv, edges.csv и три обязательных отчёта:
| Отчёт | Фиксированная схема колонок |
|---|---|
| nodes_roles.csv | gid, role, role_score, cluster_id, priority_score, evidence |
| clusters.csv | cluster_id, n_nodes, n_seed, sum_kzt_internal, top_gids, hypothesis |
| top_nodes.csv | rank, gid, role, priority_score, why |
GID исходных Parquet — int64; CSV и UI сохраняют идентификаторы без округления через float или JavaScript Number. Для поиска, ролей и связей UI достаточно пяти CSV одного запуска. Pipeline дополнительно создаёт analysis_context.json: режим расчёта, путь к источнику и контрольные суммы SHA-256.
Дневная история и дополнение метаданных из Parquet подключаются к готовым результатам только при совпадении контекста, исходных файлов и пяти CSV. После расчёта из CSV метрик либо без подтверждённого контекста исходная история не подключается: интерфейс сообщает об этом. После переноса исходных данных на другой путь повторите полный расчёт. Режим «Исходные данные» позволяет отдельно изучать Parquet без аналитических оценок.
Три обязательных отчёта по ссылкам выше включены в Git как готовый результат для приложенного датасета. Полный запуск воспроизводит их и создаёт вспомогательные output/node_metrics.csv, output/edges.csv и output/analysis_context.json; эти вспомогательные файлы остаются локальными и исключены из Git. Предоставленный набор data/ и синтетический mock/ также хранятся в репозитории.
Приложение не отправляет транзакционные данные во внешние API. Обученная AI-модель, банковская интеграция и внешняя база данных в текущей версии отсутствуют.
Ограничения
- Наблюдается один месяц внутрибанковских переводов выше порога. Переводы за другие периоды, вне банка и ниже порога не представлены.
- Входящий поток seed неполон, поэтому
pass_ratioи совместимыйpass_throughдля seed отсутствуют. Глубина 4 ограничивает дальнейшее наблюдение. Эти ограничения учитываются в правилах и пояснениях; отсутствие наблюдаемой связи не доказывает отсутствие реального перевода. role_scoreотражает силу эвристических признаков,priority_score— очередь ручной проверки. Размеченного эталона для измерения точности ролей нет; оценки не являются вероятностями.- Louvain зависит от состава и весов сети. Seed алгоритма фиксирован для воспроизводимости; обновление данных или версий библиотек может изменить сообщества.
- PageRank и betweenness экспортируются как метрики; текущие правила ролей и приоритета не используют их напрямую.
- Для обязательного TOP-20 pipeline требует минимум 20 узлов. Mock служит демонстрации интерфейса и не заменяет анализ предоставленного набора.
- Данные и граф загружаются в память. Ниже 10 000 узлов betweenness рассчитывается полностью, от 10 000 — по выборке до 500 узлов. Работа на 1 млн узлов не подтверждена: понадобятся измерения памяти и времени, потоковая агрегация, серверное хранение и фильтрация, более масштабируемые графовые вычисления. Это план развития.
- Граф UI показывает до 10 соседей на странице; остальные доступны через переключатель. Сводка по GID включает все наблюдаемые связи клиента.
- Приложение предназначено для локальной демонстрации; многопользовательский доступ и авторизация не реализованы.
Презентация для питча
docs/pitch.html — автономная HTML-презентация из 10 слайдов на пять минут. Откройте локальный файл в браузере; после клонирования репозитория дополнительные зависимости не нужны. Данные, граф и актуальный снимок интерфейса встроены в файл.
Управление: ← / → — слайды, F — полный экран, N — заметки докладчика, G — обзор слайдов, T — таймер, P — печать или сохранение PDF. Для живого демо предварительно запустите python run.py. Презентация содержит снимок результатов приложенного датасета; после изменения аналитики её цифры нужно актуализировать отдельно.
Deployed-версия и материалы
Подтверждённой ссылки на опубликованную версию в репозитории нет. Для показа используйте локальный запуск python run.py.
Скриншоты показывают интерфейс; аналитические значения могут отличаться после пересчёта:
Авторы коммитов
История коммитов
- 2026-09-23 17:21docs: align quickstart with unified launcherprintlnars
- 2026-09-23 17:21Merge remote-tracking branch 'origin/main'printlnars
- 2026-09-23 17:21docs: add quickstart guideprintlnars
- 2026-09-23 16:45docs: update README for merged main workflowprintlnars
- 2026-09-23 16:16merge: integrate updated UI and complete shared pipelineprintlnars
- 2026-09-23 16:16merge: include local data metrics history with runtime logs kept localprintlnars
- 2026-09-23 16:13merge: integrate analytics into mainprintlnars
- 2026-09-23 16:12merge: integrate data metrics into mainprintlnars
Все коммиты (53)
- 2026-09-23 16:07saddprintlnars
- 2026-09-23 15:30merge: integrate dev/ui into mainprintlnars
- 2026-09-23 15:24sadprintlnars
- 2026-09-23 15:06feat(metrics): validate parquet and generate node metricsprintlnars
- 2026-09-23 14:33dasprintlnars
- 2026-09-23 14:32feat: complete pipeline integration connecting data, metrics, analytics, export, and UIprintlnars
- 2026-09-23 14:30Merge remote-tracking branch 'origin/dev/ui'printlnars
- 2026-09-23 14:30Merge remote-tracking branch 'origin/analytics'printlnars
- 2026-09-23 14:30feat(graph-metrics): modularize loader, graph_builder, and metrics in src/printlnars
- 2026-09-23 14:20updateprintlnars
- 2026-09-23 17:46Merge remote-tracking branch 'origin/main'Aibar Argyn
- 2026-09-23 17:46Add offline TraceFlow HTML pitch deck with speaker notesAibar Argyn
- 2026-09-23 17:19Include submission CSV reports and document role thresholds in READMEAibar Argyn
- 2026-09-23 17:10Update setup instructions for integrated main branchAibar Argyn
- 2026-09-23 17:08Complete TraceFlow analytics, unified launch and verified data integrationAibar Argyn
- 2026-09-23 17:07Merge remote-tracking branch 'origin/main' into analyticsAibar Argyn
- 2026-09-23 16:58docs: add concise requirements status reviewmasqararrra
- 2026-09-23 16:55Merge current main into analytics for project readinessAibar Argyn
- 2026-09-23 16:39Simplify analytics to node metrics inputAibar Argyn
- 2026-09-23 16:07chore(ui): clean repository and support separate analytics exportsmasqararrra
- 2026-09-23 16:07Document analytics module behaviorAibar Argyn
- 2026-09-23 15:42docs(demo): refine one-minute UI walkthrough and refresh screenshotsmasqararrra
- 2026-09-23 15:42feat(ui): streamline GID investigation and validate edge exportsmasqararrra
- 2026-09-23 15:33Cluster weighted undirected transaction projectionAibar Argyn
- 2026-09-23 15:32Limit evidence to two hundred charactersAibar Argyn
- 2026-09-23 15:27Normalize priority score to zero one rangeAibar Argyn
- 2026-09-23 15:14docs(demo): add screenshots and three-GID demo scriptmasqararrra
- 2026-09-23 15:11merge: sync origin/main and validate integrated UImasqararrra
- 2026-09-23 15:08test(ui): cover real GID search and browser ID safetymasqararrra
- 2026-09-23 15:08feat(ui): add mock dashboard and preserve string GIDsmasqararrra
- 2026-09-23 15:05Document deterministic node role rulesAibar Argyn
- 2026-09-23 15:03Read node metrics without rebuilding transaction graphAibar Argyn
- 2026-09-23 14:52feat(ui): connect real data and improve investigation workflowmasqararrra
- 2026-09-23 14:25feat(ui): build TraceFlow analyst workspacemasqararrra
- 2026-09-23 14:23Merge remote-tracking branch 'origin/analytics' into analyticsAibar Argyn
- 2026-09-23 14:19Add analytics pipeline regression testsAibar Argyn
- 2026-09-23 14:15Align analytics with graph metrics contractAibar Argyn
- 2026-09-23 14:03fix(ui): show product shell while results are pendingmasqararrra
- 2026-09-23 13:51fix(ui): validate result contracts and empty statesmasqararrra
- 2026-09-23 13:49analyticsAibar Argyn
- 2026-09-23 13:47fix(ui): harden data loading and client selectionmasqararrra
- 2026-09-23 13:44feat(ui): polish analyst product interfacemasqararrra
- 2026-09-23 13:40Implement explainable network analytics pipelineAibar Argyn
- 2026-09-23 13:39feat(ui): add Streamlit analyst interfacemasqararrra
- 2026-09-23 13:27feat: initial commit with starter code and docsmasqararrra
Структура репозитория (49 файлов)
.gitattributes
.gitignore
.python-version
.streamlit/config.toml
README.md
STATUS.md
analytics.md
data/edges.parquet
data/nodes.parquet
data/transactions.parquet
docs/data-contract.md
docs/demo.md
docs/integration.md
docs/pitch.html
docs/quickstart.md
docs/screenshots/dashboard.png
docs/screenshots/top-nodes.png
docs/task.pdf
mock/clusters.csv
mock/edges.csv
mock/nodes_roles.csv
mock/top_nodes.csv
output/.gitkeep
output/clusters.csv
output/nodes_roles.csv
output/top_nodes.csv
requirements-test.txt
requirements-ui.txt
requirements.txt
run.py
src/clustering.py
src/export.py
src/graph_builder.py
src/loader.py
src/metrics.py
src/pipeline.py
src/priority.py
src/roles.py
tests/test_analytics.py
tests/test_analytics_contract.py
tests/test_data_metrics.py
tests/test_integration.py
tests/test_launcher.py
tests/test_ui.py
ui/app.py
ui/components.py
ui/data_access.py
ui/graph_view.py
ui/insights.py
Ветки (4)
Обсуждение 0 комментариев
Войдите, чтобы комментироватьПока нет комментариев — будьте первым.